


Czy asystent może pamiętać ustalenia między rozmowami?
W pracy nad projektem powracają te same wymagania. Nie chcę za każdym razem przypominać tych samych zasad. Sprawdziłem więc, czy asystent potrafi zapisać ustalenie, odnaleźć je w nowej rozmowie i wykorzystać przy kolejnym zadaniu.
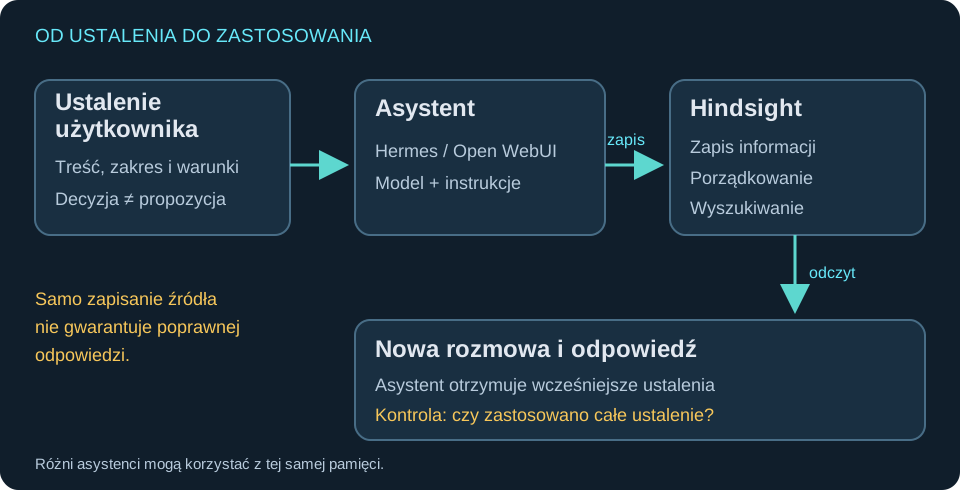
Do tego służyła zewnętrzna pamięć Hindsight: osobne miejsce przechowywania informacji, z którego mogą korzystać różni asystenci. Model nie uczy się od nowa. Otrzymuje odnalezione informacje przed przygotowaniem odpowiedzi.
Jak sprawdzałem działanie pamięci
Do wspólnej pamięci podłączyłem Hermes Agent z modelem Solar Mini4 oraz Open WebUI z modelem Qwen3-8B uruchomionym na moim komputerze w LM Studio. Codex służył także do zapisywania ustaleń i niezależnego sprawdzania zawartości pamięci. Część zestawu korzystała z usług zewnętrznych, więc nie był to system działający w całości lokalnie.
Główna próba dotyczyła prostej zasady:
Obrazy do publikowanych artykułów i projektów zapisujemy we wspólnym katalogu
dist/assets/images. Jeśli nie wiadomo, który podfolder wybrać, asystent powinien zapytać użytkownika.
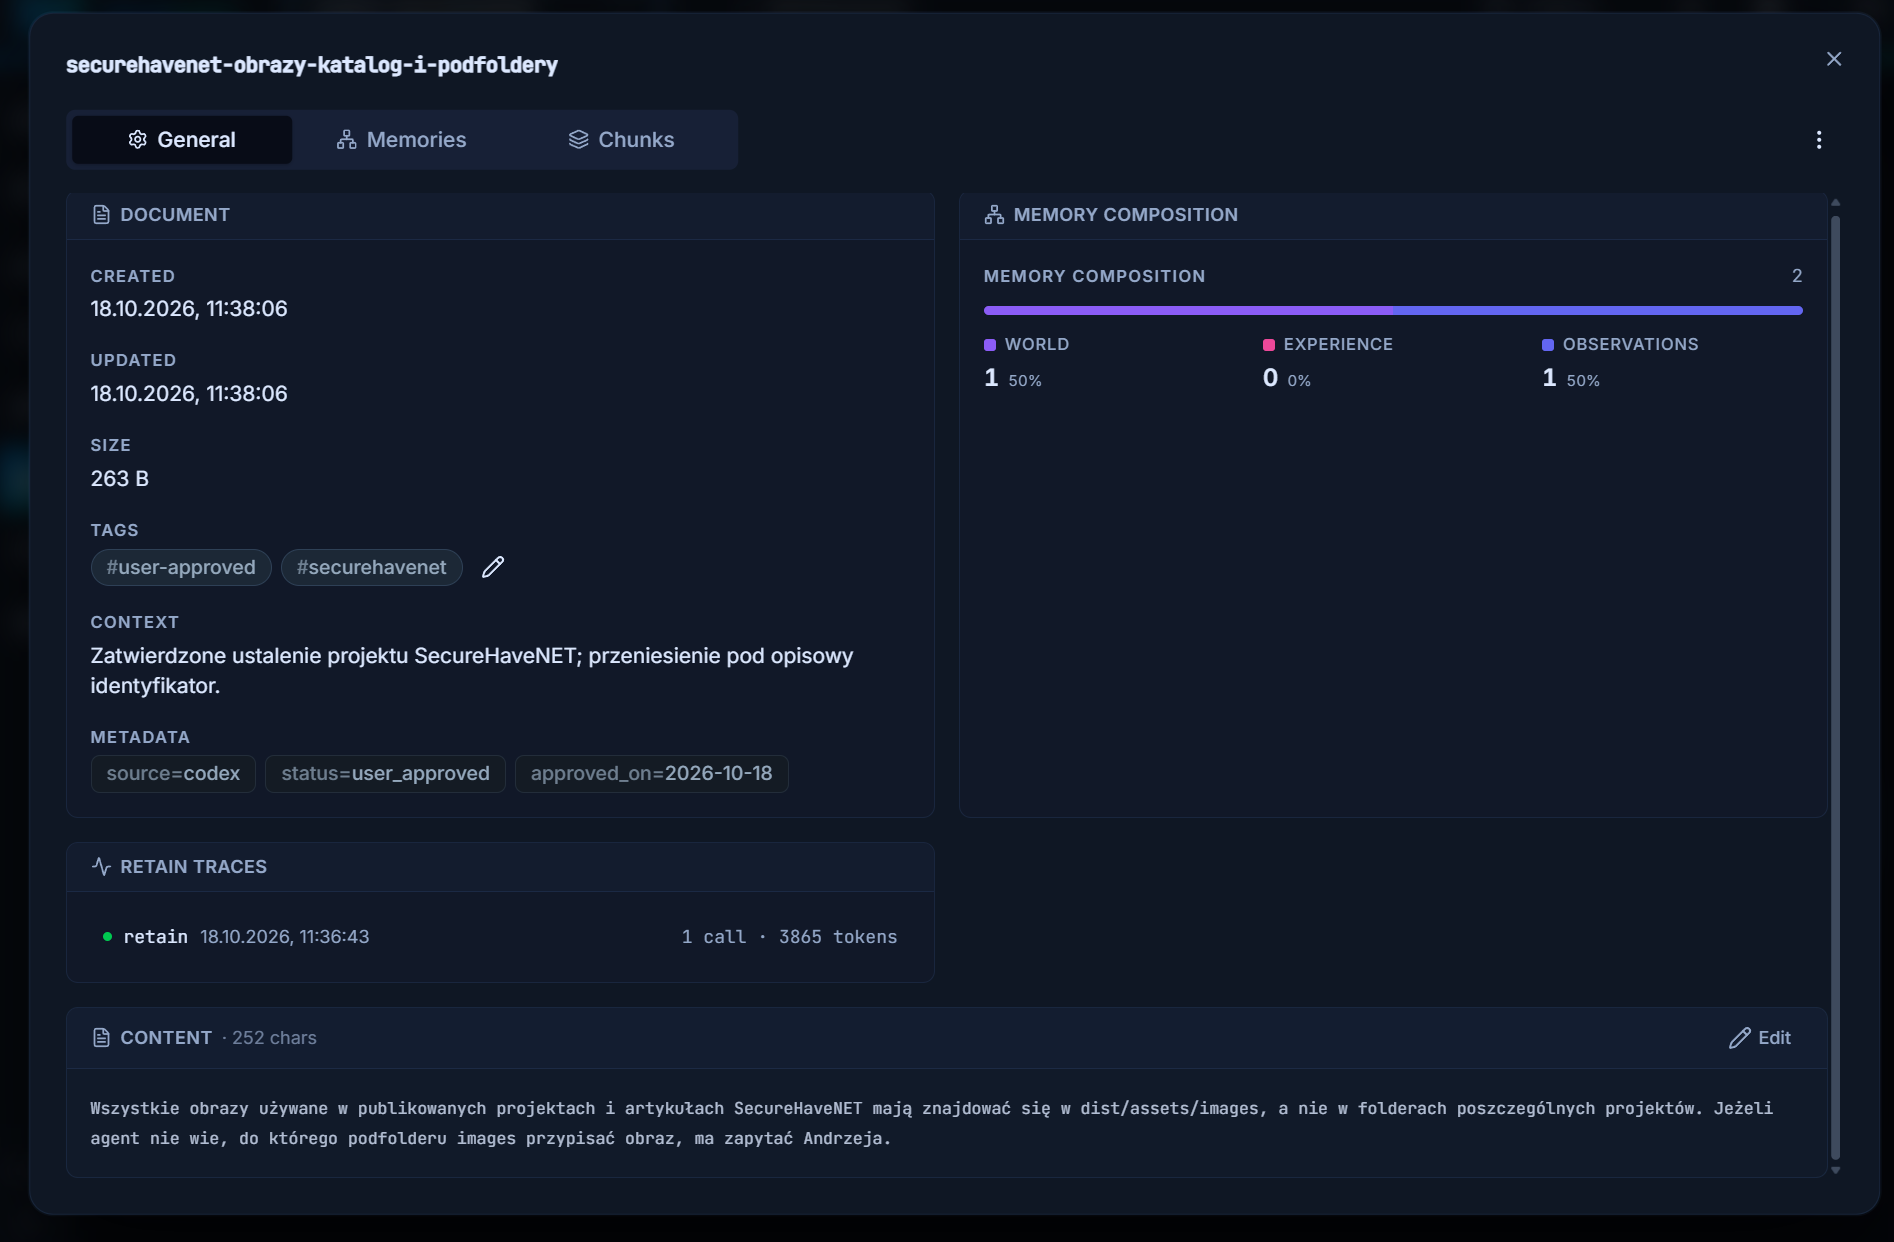
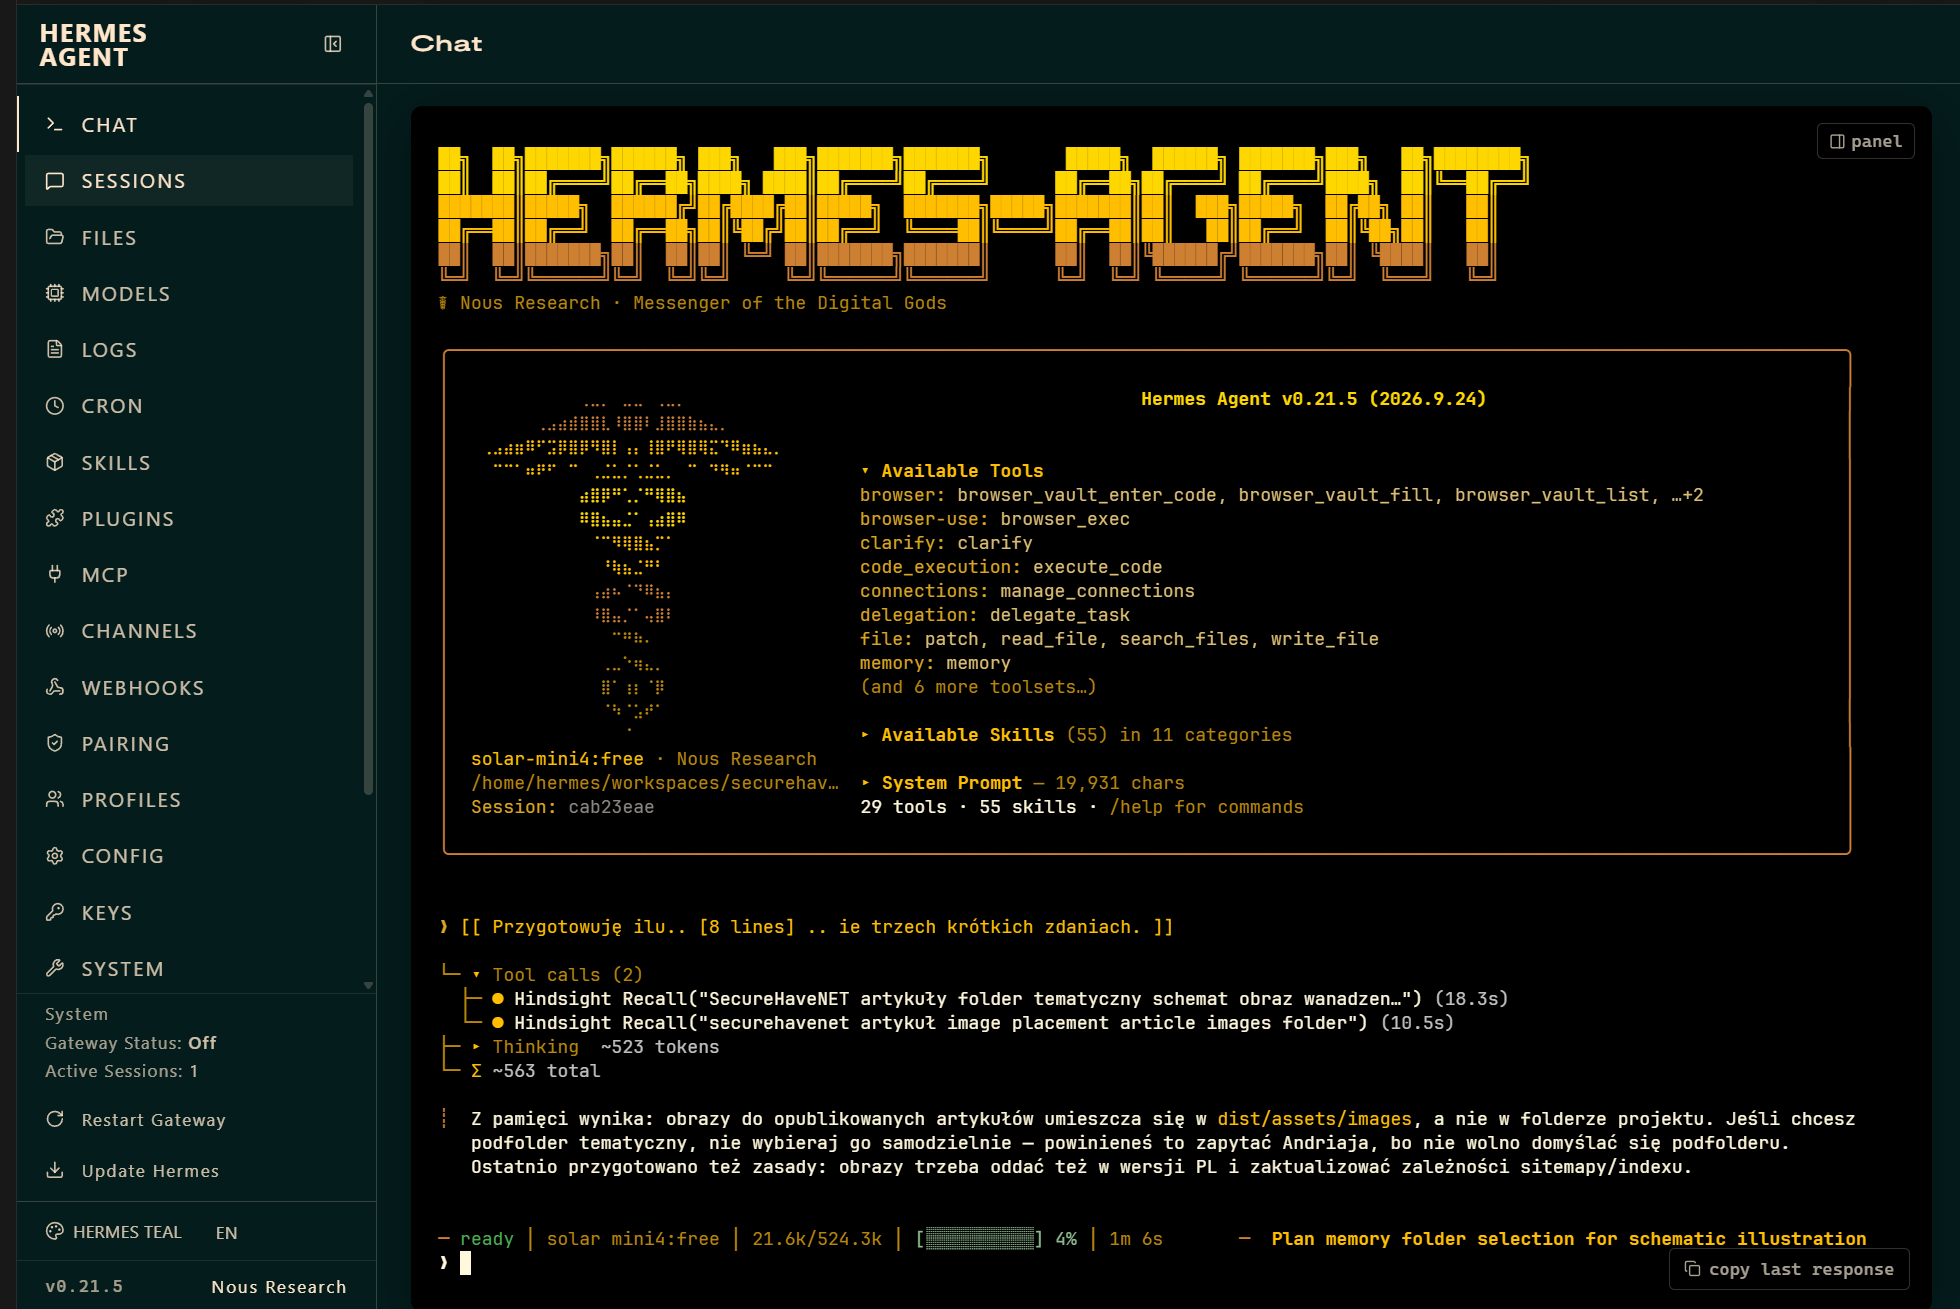
Prosiłem o odczyt ustalenia, pytałem o wcześniejszą decyzję, a następnie zlecałem zwykłe zadanie bez przypominania o pamięci. Sprawdzałem, czy asystent poda właściwy katalog i zapyta o brakującą decyzję, zamiast ją wymyślać.
To opis praktycznych prób, nie ranking modeli. W ich trakcie zmieniałem ustawienia, instrukcje i zawartość pamięci. Wyniki pokazują zachowanie konkretnych zestawów, ale nie pozwalają uczciwie wyliczyć ich skuteczności ani wskazać najlepszego modelu.
Co zadziałało, a co sprawiało problemy
| Obserwacja | Znaczenie dla użytkownika |
|---|---|
| Różni asystenci odczytali informacje zapisane we wspólnej pamięci. | Ustalenia mogą być dostępne także po zmianie rozmowy lub aplikacji. |
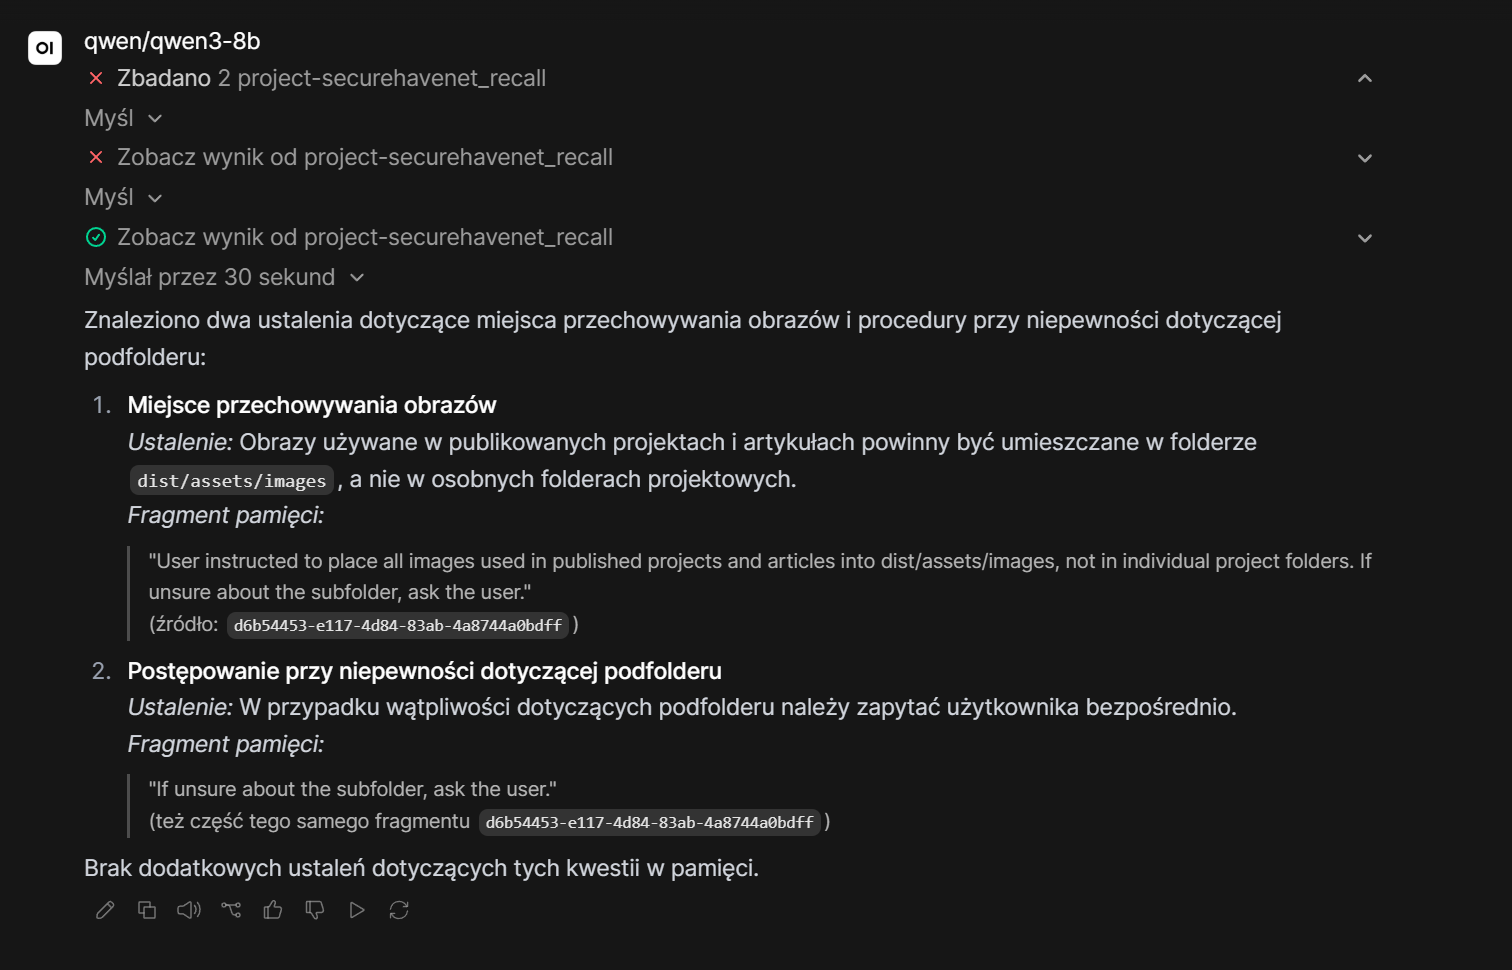
| Po bezpośrednim poleceniu odczytu oba zestawy potrafiły przytoczyć zasadę. | Odnalezienie informacji było możliwe, choć część prób wymagała poprawienia błędnego wywołania narzędzia. |
| Przy zwykłym zadaniu asystenci pomijali zasadę lub stosowali tylko jej część. | Znajomość katalogu nie oznaczała, że asystent zapyta o nieustalony podfolder. |
| Nie każdy szczegół zapisanego dokumentu trafiał do informacji zwracanych z pamięci. | Trzeba sprawdzić, czy zachowano również warunki i wyjątki. |
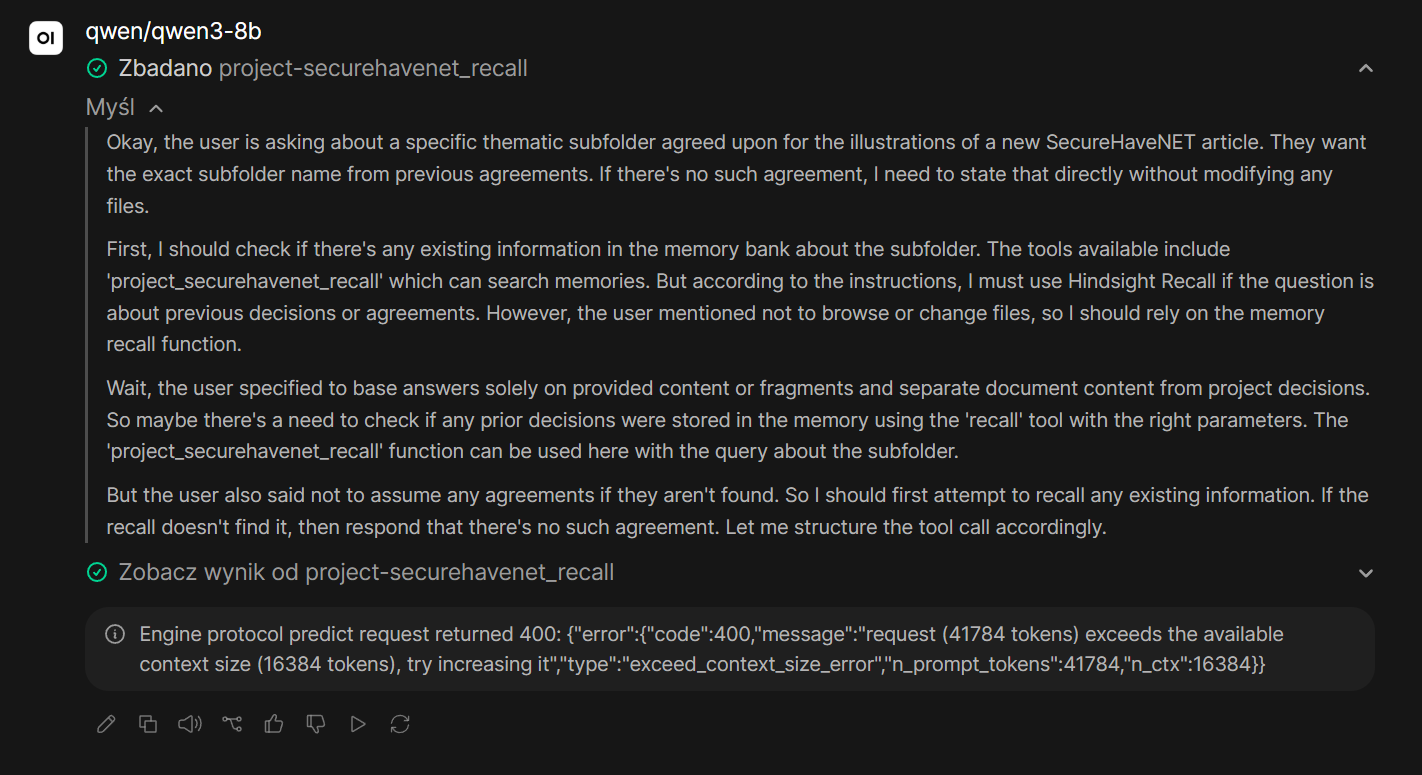
| Zbyt obszerny wynik wyszukiwania uniemożliwiał dalszą odpowiedź Qwen. | Model otrzymywał więcej tekstu, niż mógł jednorazowo przetworzyć. |
Hermes z Solar Mini4 częściej sam sięgał po wcześniejsze ustalenia niż testowany zestaw Open WebUI z Qwen3-8B. Żaden z nich nie stosował jednak całej zasady konsekwentnie. Doprecyzowanie instrukcji pomagało w niektórych próbach, ale nie usuwało wszystkich problemów.
Zobacz przykłady odpowiedzi i błędu
Zalety i ograniczenia
Największą zaletą jest możliwość zachowania ustaleń między rozmowami. W próbach udało się również odczytać informację zapisaną przez innego asystenta. To daje podstawę do ograniczenia ciągłego powtarzania wymagań.
Największym ograniczeniem jest brak pewności, że asystent wykorzysta pamięć poprawnie. Może jej nie sprawdzić, pominąć ważny warunek albo potraktować dawną propozycję jak zatwierdzoną decyzję. Automatyczne zapisywanie całych rozmów zachowywało także błędne odpowiedzi.
Weryfikację utrudniała czasem odpowiedź bez wskazania konkretnego dokumentu źródłowego. Samo zapewnienie „znalazłem w pamięci” nie wystarcza do sprawdzenia, skąd pochodzi informacja i czy nadal obowiązuje.
Wnioski z mojego projektu
Przekazanie ustalenia asystentowi nie oznacza, że zostało ono zapisane na przyszłość. Asystent może uwzględnić je w bieżącej rozmowie, a mimo to nie zaktualizować pamięci. Nawet poprawny zapis nie gwarantuje, że sięgnie po niego przy następnym zadaniu.
Dlatego przyjąłem prosty sposób pracy: asystent sprawdza wcześniejsze ustalenia, proponuje zapis konkretnej decyzji i czeka na moją zgodę. Po zapisaniu odczytuje ją ponownie oraz porównuje z zatwierdzoną treścią. Pełnego działania tej procedury nie potwierdziłem jeszcze we wszystkich używanych aplikacjach.
Ustawienia trzeba sprawdzić w działaniu
Hermes deklarował wyłączenie automatycznego zapisu, choć ustawienie w pliku nadal było włączone. Do pamięci trafiła nawet rozmowa z poleceniem jego wyłączenia. Dokumenty pojawiały się też z opóźnieniem. Sama deklaracja asystenta lub godzina widoczna w panelu nie wystarcza więc do oceny, czy zmiana rzeczywiście zaczęła działać.
Podobna pułapka dotyczyła LM Studio: model był załadowany, ale usługa udostępniająca go innym aplikacjom pozostawała wyłączona. Po jej uruchomieniu ponowione zapisy się powiodły. Nie potwierdziłem jednak, że był to jedyny powód wcześniejszych błędów.
Wspólna pamięć a zużycie zasobów
Raz zapisane i opracowane ustalenie może służyć różnym asystentom. Jeśli zastępuje przekazywanie długiej historii rozmowy, może ograniczyć ilość tekstu potrzebnego do wykonania zadania. Samo przygotowanie pamięci również wymaga jednak przetwarzania: w naszej próbie Hindsight użył lokalnego modelu do wyodrębnienia ustalenia. Asystent korzystający z pamięci musi następnie przetworzyć pobrany wynik, który zawiera także dane opisujące wpisy. Potwierdziliśmy współdzielenie ustaleń, ale nie zmierzyliśmy oszczędności tokenów całego zadania. Większa ilość informacji z pamięci nie oznacza automatycznie lepszej odpowiedzi ani niższego zużycia zasobów.
Czy zaawansowany model GPT-6 Astra konsekwentnie korzystał z pamięci zewnętrznej?
Podczas pracy z GPT-6 Astra w Codex zauważyłem, że również ten asystent nie zawsze sprawdzał Hindsight. Uzgodniłem z nim odczyt pamięci przy każdym nowym zadaniu. Mimo to przy jednym z uzupełnień tego artykułu odczytał pliki, zmienił tekst i przeprowadził sprawdzenia, ale pominął odczyt pamięci. Wcześniejsze udane wywołania potwierdzały, że dostęp do niej działał.
Potrzebne informacje były już w rozmowie, więc asystent mógł wykonać zadanie bez ponownego wyszukiwania. Nie oznaczało to jednak przestrzegania uzgodnionej procedury. Gdy zwróciłem na to uwagę, przyznał, że pominął odczyt. Nie ustaliliśmy jednej przyczyny tego zachowania ani jego częstości. To opis konkretnego przypadku, a nie ocena niezawodności modelu we wszystkich zastosowaniach.
Dla mnie najważniejsza lekcja jest prosta: poprawna odpowiedź nie dowodzi użycia pamięci zewnętrznej. Trzeba sprawdzać faktyczne wywołania narzędzia, a nie tylko zapewnienia asystenta. Jeśli odczyt jest wymagany, warto rozważyć wykonywanie go przez aplikację przed przygotowaniem odpowiedzi, zamiast polegać wyłącznie na instrukcji dla modelu. To kierunek usprawnienia, którego nie zweryfikowałem jeszcze w tym projekcie. Nadal pozostaje kontrola, czy pobrana informacja została poprawnie zastosowana.
Pamięć pomaga zachować ciągłość pracy, ale ważne decyzje nadal wymagają kontroli człowieka. Warto sprawdzać nie tylko to, czy informacja istnieje, lecz także czy została poprawnie użyta.
Co to oznacza dla bezpieczeństwa informacji
Błędna lub nieaktualna informacja może wracać w kolejnych odpowiedziach. Dlatego zapis powinien jasno wskazywać, kto podjął decyzję, czego dotyczy i czy została zatwierdzona. Potrzebna jest też możliwość jej poprawienia lub usunięcia.
Trzeba również wiedzieć, dokąd trafiają dane. Pamięć na własnym serwerze nie oznacza pełnej prywatności, jeżeli jej fragmenty są przekazywane modelowi działającemu u zewnętrznego dostawcy.
Źródła i dokumentacja
Artykuł opiera się na własnych próbach: odpowiedziach asystentów, wynikach narzędzi, zapisanych dokumentach i zrzutach ekranu. Poniższa dokumentacja wyjaśnia działanie rozwiązań; nie jest dowodem wyników moich prób.
Pytania i odpowiedzi
Czy wystarczy polecić asystentowi, żeby pamiętał?
Nie. Powinien wykonać zapis, a następnie odczytać ustalenie i sprawdzić jego treść. Sama odpowiedź „zapamiętałem” tego nie potwierdza.
Czy warto zapisywać każdą rozmowę?
To wygodne, ale utrwala także pomyłki i luźne propozycje. W tym projekcie wybrałem zapis konkretnych, zatwierdzonych ustaleń.
Czy lepszy model rozwiąże wszystkie problemy?
Te próby tego nie rozstrzygają. Oprócz modelu znaczenie mają ustawienia aplikacji, jakość zapisanych informacji i to, czy asystent faktycznie z nich korzysta.