


Problem: odpowiedź musi wynikać z dokumentu
Chciałem zadawać pytania o własne dokumenty i otrzymywać odpowiedzi, które zachowują ich treść, warunki oraz wyjątki. Samo wskazanie źródła nie wystarczało: model mógł otrzymać niepełny fragment albo błędnie wykorzystać dostępne informacje.
W procedurze uprawnień pominięty warunek może zmienić sens zalecenia. Nawet proste pytanie o nazwę zabezpieczenia wymaga dokładnego dopasowania, a nie wskazania podobnej pozycji. Potrzebowałem więc sprawdzić osobno wyszukiwanie i zgodność odpowiedzi ze źródłem.
Dokumenty ISMS i procedury są wymagającym materiałem dla RAG: pominięcie warunku, wyjątku lub zakresu odpowiedzialności może zmienić sens odpowiedzi. Lokalne uruchomienie pozwala ograniczyć przekazywanie treści poza własne środowisko i zwiększyć kontrolę nad danymi. Poufność nadal zależy od konfiguracji usług, dostępu i przechowywania danych.
Próby miały pomóc ustalić, gdzie powstaje błąd i czy dodatkowa konfiguracja daje korzyść wartą utrzymania.
RAG - krótkie definicje
Celem było uzyskanie odpowiedzi zgodnej z własnym dokumentem. RAG dostarcza modelowi wybrane fragmenty, które trzeba ocenić razem z odpowiedzią.
| Pojęcie | Znaczenie | W tym projekcie |
|---|---|---|
| RAG | Wyszukanie materiału i dołączenie go do pytania przed wygenerowaniem odpowiedzi. | Własny wariant, później RAG Open WebUI. |
| Fragment (chunk) | Część dokumentu przygotowana do wyszukania, np. kilka pozycji listy zabezpieczeń. | Listy pozycji i nagłówki; sprawdzałem, co trafia do kontekstu. |
| Embedding | Liczbowa reprezentacja tekstu używana do wyszukiwania podobieństwa. | Element indeksowania dokumentów. |
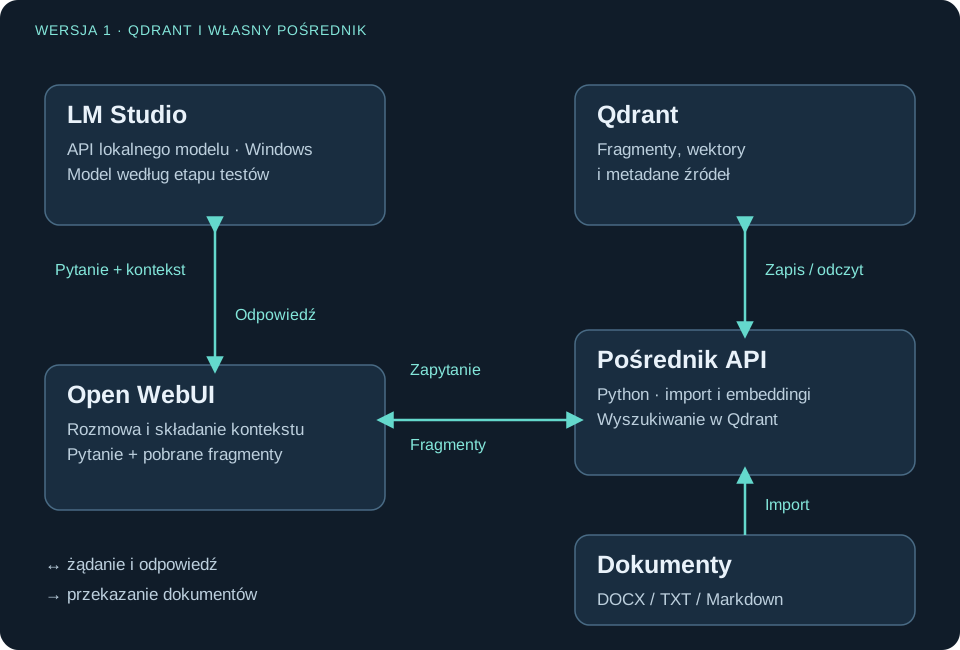
| Qdrant | Baza przechowująca wektory i pozwalająca je przeszukiwać. | W pierwszym wariancie z własnym importerem. |
| Wyszukiwanie hybrydowe | Łączy dopasowanie semantyczne ze słowami kluczowymi. | Włączone w ustawieniach późniejszej serii. |
| Reranking | Ponowne uporządkowanie znalezionych fragmentów, aby wyżej znalazły się te lepiej pasujące do pytania. | Konfigurowany w Open WebUI; sam wpis w ustawieniach nie dowodzi wykonania modelu. |
| GraphRAG | Wariant RAG wykorzystujący graf powiązań między informacjami. | Nie testowano. |
| Dostrajanie modelu | Dodatkowe uczenie zmieniające parametry modelu. Osobna metoda, nie etap wyszukiwania RAG. | Nie testowano. |
Testowane rozwiązania
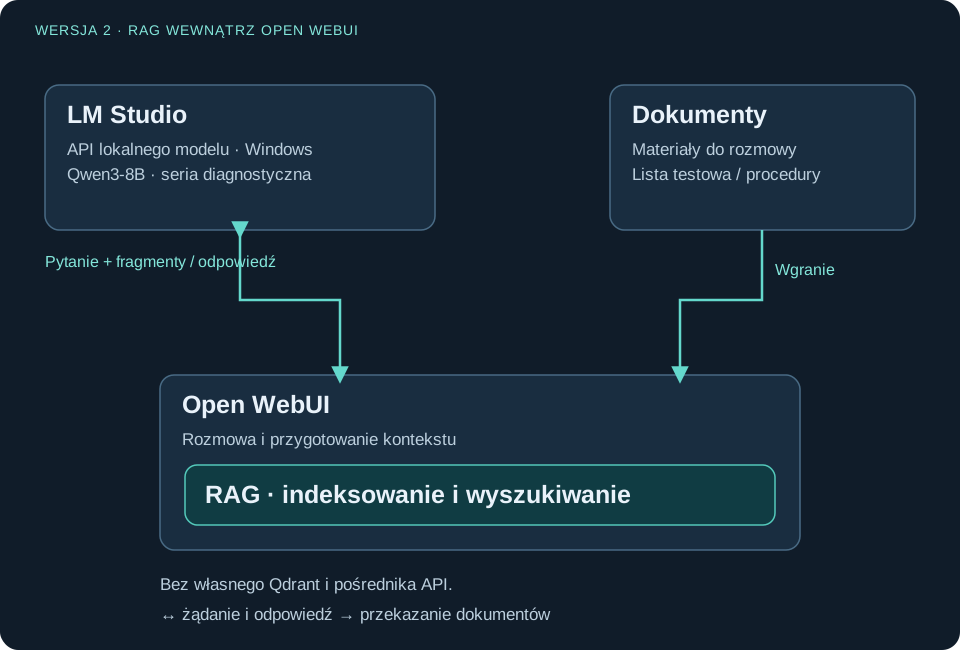
Model udostępniałem przez LM Studio, a rozmowy prowadziłem w Open WebUI. Sprawdzałem dwa sposoby dostarczenia dokumentów: własną integrację z Qdrant oraz wbudowany RAG Open WebUI.
Własny importer i Qdrant
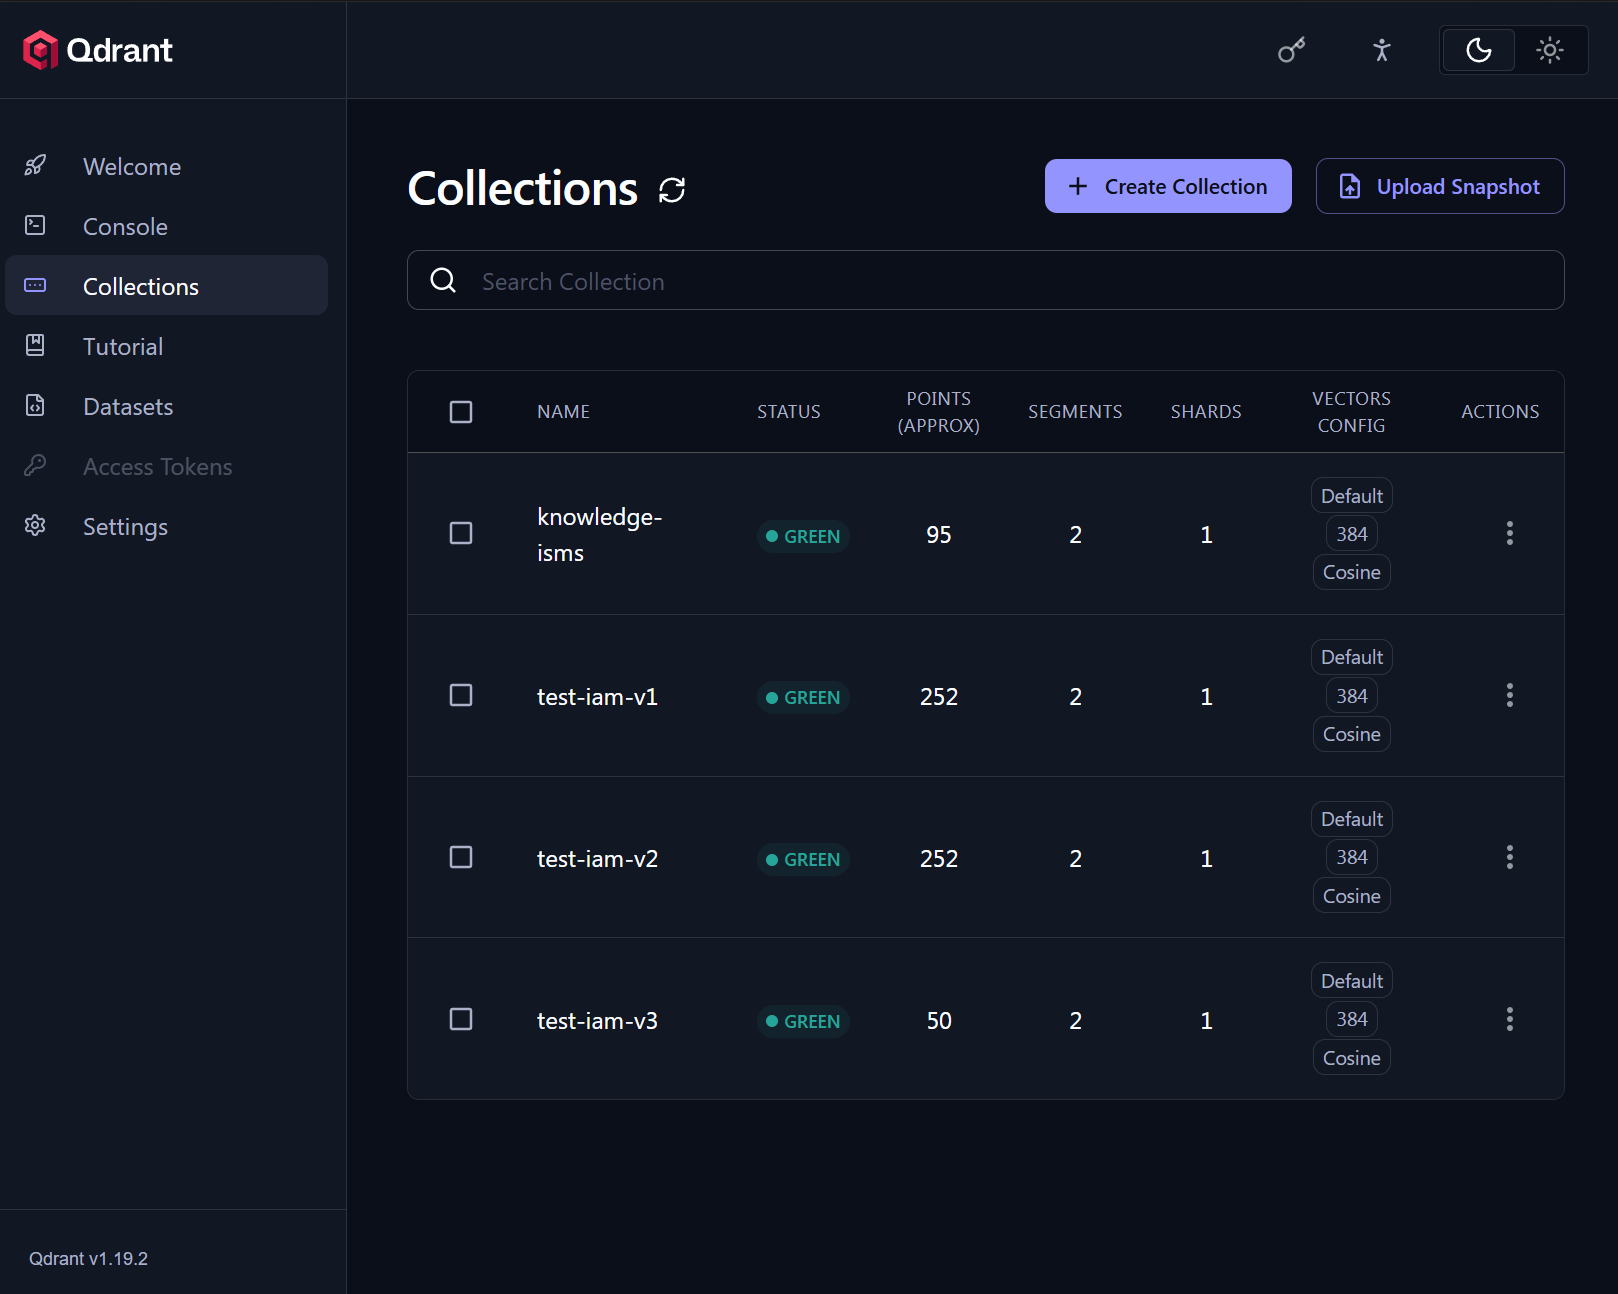
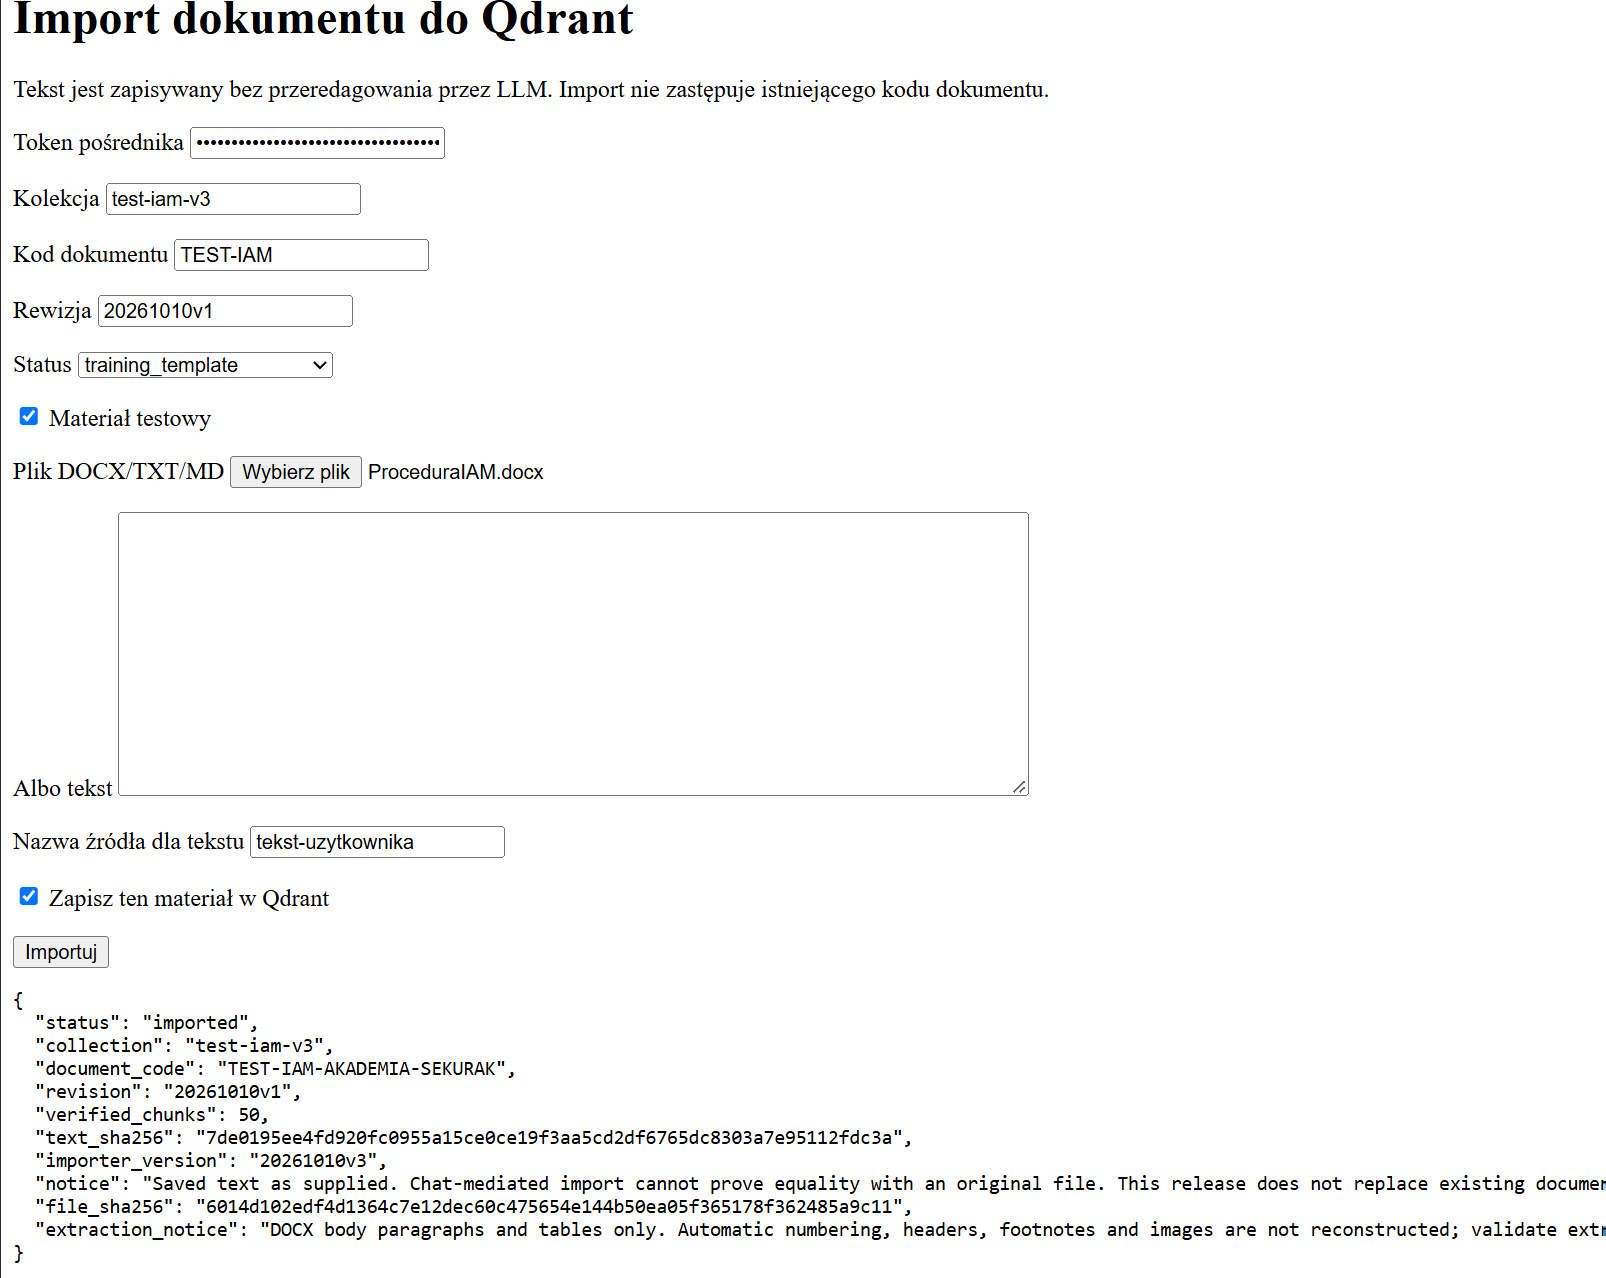
Importer przygotowywał fragmenty i embeddingi, a pośrednik API udostępniał wyszukiwanie. Kontrolowałem import, wyniki wyszukiwania i odpowiedzi na pytania o procedurę IAM.
RAG wewnątrz Open WebUI
Następnie uprościłem obsługę dokumentów, korzystając z mechanizmu Open WebUI. Ograniczyło to utrzymanie własnego kodu integracji. Jakość pobierania i odpowiedzi nadal sprawdzałem osobno.
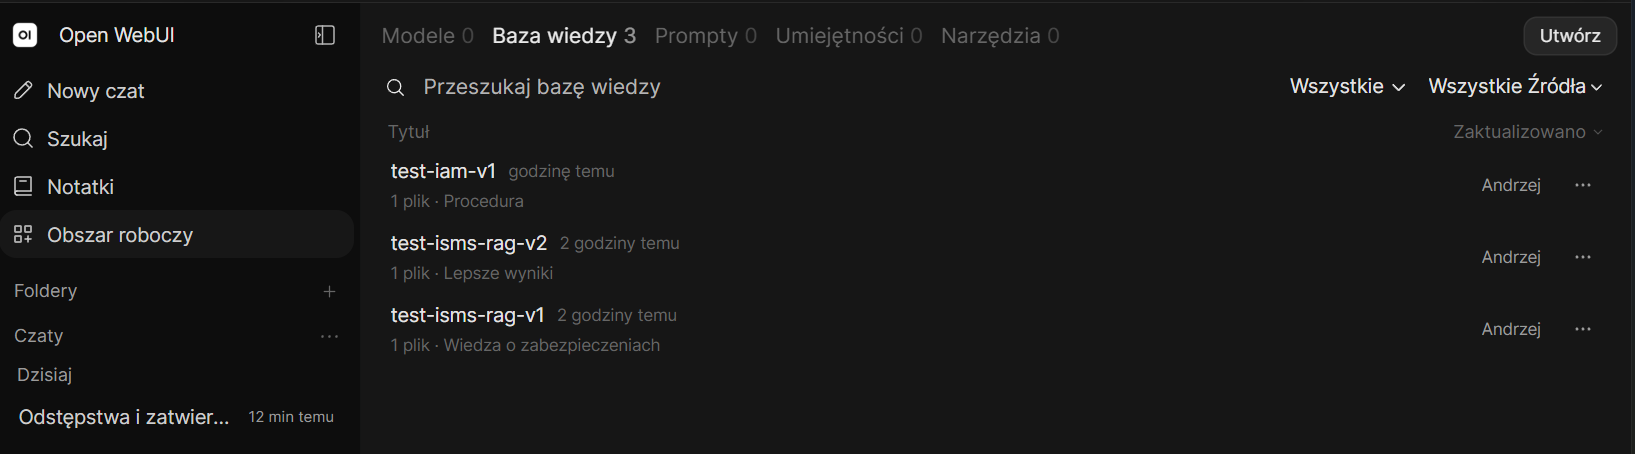
Widok baz wiedzy Open WebUI
Metodologia testów
To opis przypadku, nie ranking modeli. Pierwszy etap dotyczył integracji i procedury IAM. W późniejszych próbach użyłem krótkiej listy zabezpieczeń z jednoznacznymi odpowiedziami kontrolnymi.
- Dokument: autorska lista 93 nazw zabezpieczeń w czterech grupach, z nieoficjalnymi tłumaczeniami. Nie jest to pełna norma ani instrukcja wdrożenia.
- Pytanie o pozycję: dokładny identyfikator i nazwa zabezpieczenia dotyczącego korzystania z usług chmurowych. Oczekiwano A.5.23 i nazwy zgodnej z listą.
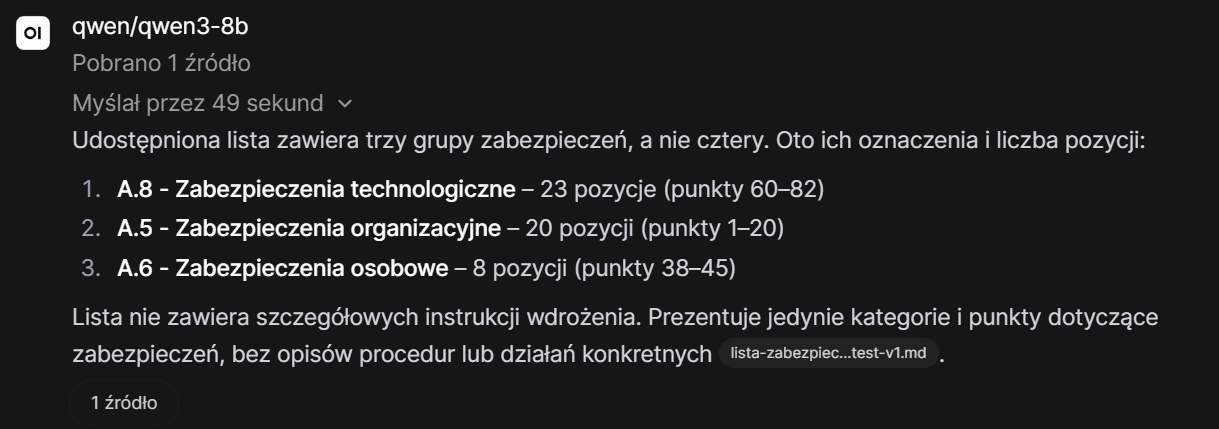
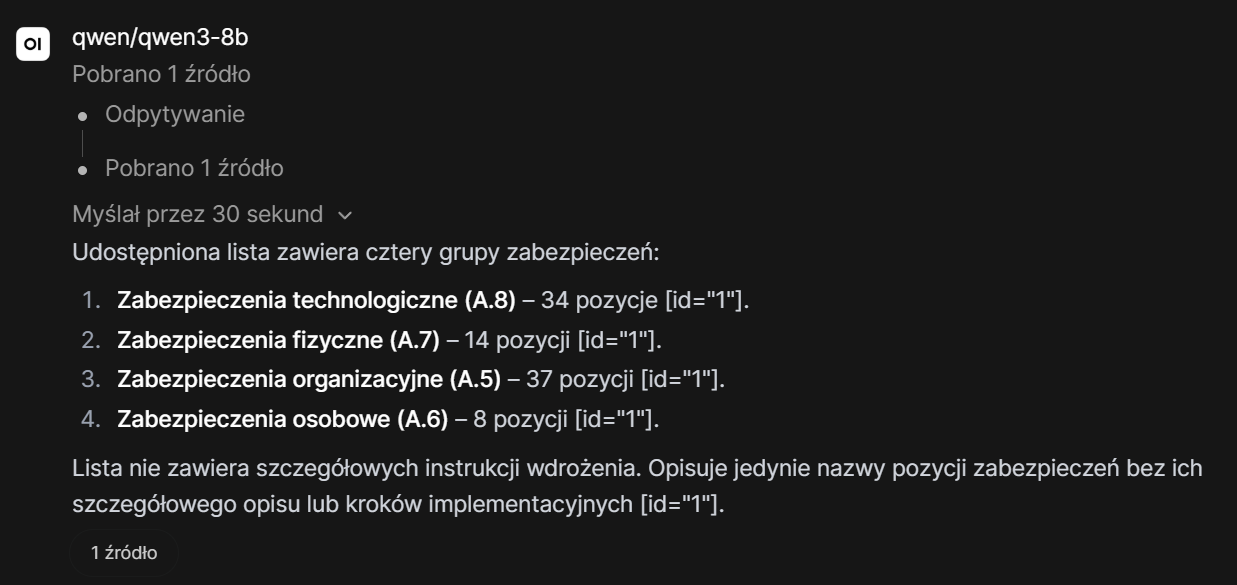
- Pytanie o strukturę: cztery grupy, ich liczebności i informacja, czy materiał zawiera instrukcje wdrożenia. Oczekiwano A.5: 37, A.6: 8, A.7: 14, A.8: 34 oraz braku takich instrukcji.
- Historia rozmowy: każdą próbę rozpoczynałem w nowym czacie, bez wcześniejszych pytań, odpowiedzi i korekt. Nie porównywałem tych wyników z rozmową zawierającą historię, dlatego nie oceniam, czy jej zachowanie poprawiłoby lub pogorszyło odpowiedzi.
- Kontrole: poprawny fragment podany wprost, zmiana limitu i powrót do poprzedniej wartości, oryginał listy i wariant z nagłówkami ###.
- Dowody: treść źródła, widoczne pobrane fragmenty i odpowiedź końcowa. Tekst „Myśl” był dodatkowym śladem, nie dowodem poprawności.
Ograniczenia: pojedyncze próby diagnostyczne, niepełne logi efektywnych ustawień i brak pełnego zapisu wszystkich żądań. Panel źródeł nie dowodzi, że odczytano cały dokument. Nie wyliczam procentowej skuteczności ani przewagi sprzętu.
Zmiany pytania i parametrów nie tworzą pełnego kontrolowanego eksperymentu. Poprawę po zmianie opisuję jako obserwację, a nie automatycznie jako jej skutek.
Aspekty techniczne i wyniki
Jak oceniam odpowiedź
- Dobór pozycji: A.5.23 i dokładna nazwa z materiału. Inna pozycja to błąd merytoryczny.
- Precyzja identyfikatora: „23.” jest numerem porządkowym listy. „23. A.5.23” oznacza trafny wybór, lecz nie spełnia wymagania dokładnego identyfikatora.
- Kompletność: przy pytaniu o grupy wymagane są wszystkie cztery grupy i właściwe liczebności.
- Wierność źródłu: dodatkowe twierdzenie bez potwierdzenia jest błędem, nawet jeśli główna odpowiedź jest trafna. Brak pełnego odczytu nie pozwala orzekać o całym dokumencie.
Według tych kryteriów opisuję wyniki; nie wyliczam na ich podstawie zbiorczej punktacji.
Środowisko i ustawienia
| Element | Zapis z prób |
|---|---|
| Środowisko | LM Studio i Open WebUI; wcześniejszy wariant z własnym importerem i Qdrant. Laptop z RTX 4060 Laptop 8 GB, usługi pomocnicze w środowisku Linux. |
| Modele | Wcześniejsze próby pracy z dokumentami: Qwen2.5-7B-Instruct. Późniejsza seria na liście zabezpieczeń: Qwen3-8B, GGUF Q4_K_M, kontekst 16 384. Wyniki tabeli dotyczą tej późniejszej serii, chyba że zaznaczono inaczej. Nie jest to porównanie modeli. |
| Podział dokumentu | W ustawieniach: 1000 znaków, overlap 100 (100 znaków wspólnych dla sąsiednich fragmentów). Embedding: all-MiniLM-L6-v2. |
| Pobieranie | Tryb pełnego kontekstu (przekazanie całego dokumentu zamiast wybranych fragmentów) wyłączony, hybrydowy włączony. Top K = 5; parametr Top K Reranker, związany z limitem wyników przy ponownym rankingu, zmieniany 3 → 5 → 3; próg trafności = 0. |
| Reranker | W polu modelu BAAI/bge-reranker-v2-m3. Brak pełnego śladu wykonania, więc nie przypisuję wyników wyłącznie temu modelowi. |
| Niepełne dane | Nie potwierdzono temperatury każdej rozmowy ani pełnego kontekstu każdego żądania. Czas „myślenia” z interfejsu nie jest pomiarem całej ścieżki. |
Jak samemu wykonać podobny test
- Ustal wzorzec. Wybierz dokument i pytanie z jednoznaczną odpowiedzią. Zapisz wymagane informacje oraz twierdzenia, których źródło nie potwierdza.
- Zachowaj przebieg. Zapisz pytanie, ustawienia, pobrane fragmenty i odpowiedź. Oznacz dane, których nie udało się sprawdzić.
- Rozdziel przyczyny błędu. Sprawdź najpierw, czy pobrano potrzebną treść, a następnie, czy model poprawnie ją wykorzystał.
- Zmień jeden element. Powtórz to samo pytanie w nowej rozmowie. W razie poprawy wykonaj kontrolę, np. powrót do poprzedniej wartości. Pojedynczy sukces nie dowodzi stałej skuteczności.
Poniżej znajdziesz pytanie i fragment listy do próby odczytu. Test wyszukiwania wymaga wgrania pełnego dokumentu.
Szczegółowy zapis prób
Wszystkie poniższe próby dotyczyły Qwen3-8B i pytania P1. Ustawienia bazowe podano wyżej. Nie zachowano pełnych żądań do modelu ani niezależnego potwierdzenia wszystkich ustawień każdej próby.
P1: Na podstawie udostępnionej listy podaj dokładny identyfikator i nazwę zabezpieczenia dotyczącego korzystania z usług chmurowych. Nie dodawaj opisu wdrożenia. Jeśli nie masz dostępu do listy, zaznacz to.
Pytanie pochodzi z protokołu; nie jest widoczne na każdym zrzucie odpowiedzi.
| Próba i konfiguracja | Widoczne fragmenty | Odpowiedź i ocena |
|---|---|---|
| R-P1-01 Oryginał, stan bazowy | A.8.1–23, A.6.1–8, A.5.1–20. Brak A.5.23 w panelu. | A.5.20. Błędny wybór pozycji. |
| D-R-01 Top K Reranker 3 → 5, według operatora | Pięć fragmentów. Pierwszy: A.5.20–35, zawiera A.5.23. | A.5.23 i właściwa nazwa. Poprawna odpowiedź. |
| D-R-RETURN3-01 Powrót do 3 według protokołu; brak zrzutu ustawień | Trzy fragmenty, odpowiadające pierwszym trzem z D-R-01. A.5.23 dostępne. | „23. A.5.23”, właściwa nazwa. Trafny wybór, błąd precyzji identyfikatora. |
| D-STRUCT A/B Oryginał / nagłówki ###; stałe ustawienia według protokołu | A: panel nieprzekazany. B: osobne nagłówki A.5.23, A.8.21, A.7.4. | A: poprawny identyfikator i nazwa. B: właściwy punkt, ale „23.” dołączone do identyfikatora. Brak wykazanej poprawy. |
Fragment materiału do własnej próby
Własne tłumaczenia z listy testowej, nie oficjalny tekst normy:
19. A.5.19 Bezpieczeństwo informacji w relacjach z dostawcami
20. A.5.20 Uwzględnianie bezpieczeństwa informacji w umowach z dostawcami
23. A.5.23 Bezpieczeństwo informacji przy korzystaniu z usług chmurowych
Oczekiwana odpowiedź: A.5.23 Bezpieczeństwo informacji przy korzystaniu z usług chmurowych. Ten wycinek pozwala sprawdzić odczyt informacji. Nie odtwarza wyszukiwania w całej liście 93 pozycji.
Praca z dokumentami
| Próba | Zaobserwowany wynik | Co z tego wynika |
|---|---|---|
| Brak właściwego fragmentu | Panele źródeł kończyły A.5 na punkcie 20. W próbie RAG model wskazał A.5.20 zamiast A.5.23. | Wynik pobierania był niepełny, a model dodatkowo zgadywał. |
| Liczenie grup | Model podał trzy grupy oraz 20 i 23 pozycje, mimo nagłówków wskazujących 37 i 34. Nie pobrano A.7. | Dwa problemy: brak fragmentu i błędne użycie informacji już dostępnej. |
| Pełniejsze źródła | Po pobraniu wstępu i czterech nagłówków podał poprawnie: A.5 = 37, A.6 = 8, A.7 = 14, A.8 = 34. | W tym przypadku odpowiedź była zgodna ze źródłem. |
| Limit 3 → 5 → 3 | Po zwiększeniu pojawił się A.5.23 i poprawna odpowiedź. Po powrocie do 3 właściwy fragment nadal był pobierany. | Nie potwierdzono, że sam wzrost limitu naprawił problem. |
| Nagłówki ### | Oryginał i wariant z nagłówkami wskazały A.5.23. Wariant z nagłówkami zwrócił pojedyncze pozycje; dla oryginału w tej parze nie zachowano panelu źródeł. | Zmienił się pobrany materiał, lecz nie wykazano poprawy jakości odpowiedzi. |
| Dokładność identyfikatora | W części odpowiedzi wskazujących właściwe zabezpieczenie model podawał „23. A.5.23”. | Trafna pozycja, ale numer porządkowy został błędnie włączony do identyfikatora. |
| „Przeszukaj cały dokument” | Model wskazał punkt i dodał stwierdzenia o pozostałej treści. Brak dowodu pełnego odczytu. | Polecenie nie potwierdza kompletnego przeszukania. |
Dowód: błędna i poprawna odpowiedź o grupach
Wcześniejsze próby integracji
| Zdarzenie | Wynik i znaczenie |
|---|---|
| Przekroczenie kontekstu | Żądanie 17 330 tokenów przy limicie 16 384 zakończyło się HTTP 400. Najpierw trzeba zapewnić wykonanie żądania. |
| Procedura IAM | Po zmianach importera pełniejszy fragment odstępstw znalazł się w wynikach wyszukiwania, ale odpowiedź nadal pomijała istotne warunki. |
Poprawki i ich efekty
| Zmiana | Efekt | Pozostały problem |
|---|---|---|
| Uproszczenie integracji | Przejście do RAG Open WebUI ograniczyło utrzymanie własnego importera i pośrednika. | Jakość odpowiedzi nadal wymagała testów. |
| Kontrola pobranych fragmentów | Pozwoliła odróżnić brak A.5.23 od błędu interpretacji nagłówków. | Sam poprawny fragment nie usuwa dopowiedzeń. |
| Zmiana struktury listy | W panelu źródeł wariantu z nagłówkami widoczne były pojedyncze pozycje. | Brak wykazanej przewagi odpowiedzi; pozostał błąd identyfikatora. |
Nie uznaję zmiany K za potwierdzoną naprawę. W zebranych próbach nie wykazałem również konieczności zmiany embeddingu. Kolejna zmiana powinna odpowiadać na konkretny, odtworzony błąd.
Wnioski z prób
- Sprawdzam trzy rzeczy osobno: czy żądanie się wykonało, czy pobrano właściwe dane i czy odpowiedź zachowała ich znaczenie.
- Odróżniam „nie znaleziono” od „nie istnieje”. Wybór fragmentów ogranicza to, co można stwierdzić o całym dokumencie.
- Sprawdzam wyjątki i warunki. W procedurze IAM pominięcie warunku zmienia sens odpowiedzi, nawet gdy pobrany fragment jest trafny.
- Nie oceniam skuteczności po liczbie źródeł. Jeden dokument może dostarczyć kilka fragmentów, a poprawny odnośnik nie dowodzi poprawnego wniosku.
- Stosuję małe testy rozstrzygające. Powrót do poprzedniej wartości i kontrola z właściwym fragmentem dały więcej informacji niż kolejne przypadkowe strojenie.
Wnioski z mojego projektu
W skrócie
Sprawdziłem, czy lokalny model potrafi odnaleźć i poprawnie wykorzystać informacje z dokumentów. Błędy występowały zarówno przy pobieraniu fragmentów, jak i interpretacji dostępnej treści. Praktyczny wniosek: oceniaj osobno źródło, pobrany kontekst i końcową odpowiedź. Samo zwiększenie limitu wyników nie zostało potwierdzone jako naprawa.
Właściwy fragment jest warunkiem dobrej odpowiedzi, ale nie jej gwarancją. W próbach wystąpiły zarówno braki pobierania, jak i pomijanie informacji już obecnej w kontekście. Dlatego sprawdzam dokument, pobrane fragmenty i odpowiedź jako osobne etapy.
Dla mojego zastosowania wybrałem prostszą obsługę dokumentów w Open WebUI. To decyzja o koszcie utrzymania integracji, nie ogólna ocena Qdrant ani dowód przewagi jednej architektury.
Nie wykazałem, że samo zwiększenie K lub dodanie nagłówków poprawia odpowiedzi. Wykazałem natomiast konkretne przypadki zgodnego odczytu po dostarczeniu potrzebnej treści. W zadaniach GRC nadal kontroluję istotne warunki bezpośrednio w źródle.
Granica zastosowania na tym etapie: opisane próby nie potwierdziły, że testowane rozwiązanie niezawodnie zachowuje treść dokumentu, w tym jego warunki i wyjątki. Traktuję je jako pomoc w wyszukiwaniu informacji, a nie samodzielną podstawę decyzji dotyczących uprawnień, ryzyka lub zgodności. Przed wykorzystaniem odpowiedzi sprawdzam ją w źródle. Wniosek dotyczy opisanego środowiska i prób, nie wszystkich rozwiązań RAG.
Znaczenie dla bezpieczeństwa informacji i GRC
- Problem: odpowiedź może brzmieć wiarygodnie mimo niepełnego kontekstu lub pominięcia warunku obecnego w źródle.
- Ryzyko: wykorzystanie takiej odpowiedzi bez sprawdzenia może prowadzić do błędnej decyzji lub oceny zgodności.
- Wymagania: przed podjęciem decyzji należy zweryfikować warunki i wyjątki w dokumencie. Warto zachować pytanie, wersję źródła, ustawienia, pobrane fragmenty i odpowiedź jako ślad weryfikacji, zaznaczając brakujące dane. Sam zapis fragmentów nie dowodzi poprawności odpowiedzi ani przeszukania całego dokumentu.
Moje obserwacje a badania innych
Poniższe publikacje są punktem odniesienia, a nie niezależnym potwierdzeniem skuteczności mojego środowiska. Korzystam ze wskazanych wersji preprintów.
| Publikacja | Związek z moimi próbami | Granica porównania |
|---|---|---|
| AquiLLM, wersja 3 | Autorzy opisują większą niezawodność przy bezpośrednim wyszukiwaniu niż przy syntezie i rozstrzyganiu niejednoznaczności. Moje błędy pominięć i dopowiedzeń są zbieżne z potrzebą osobnej oceny wierności. | Inna dziedzina, środowisko i metodologia. Nie odtworzyłem badania ani nie porównałem wyników liczbowych. |
| Faithfulness-QA, wersja 2 | Praca proponuje dane do badania, czy model trzyma się kontekstu mimo konfliktu z wiedzą wyuczoną. W moich próbach również ważna była zgodność ze źródłem. | Nie użyłem tego zbioru ani kontrolowanych podmian encji. Pytania o listę zabezpieczeń nie odtwarzają tej metody. |
Wniosek: obserwacje wspierają potrzebę kontroli wierności odpowiedzi. Nie potwierdzają skuteczności metod treningowych, przewagi architektury ani skali efektów raportowanych przez innych.
Źródła i dokumentacja
Podstawą wyników są własne materiały testowe, zrzuty i zapisy wywołań z października 2026. Dokumentacja poniżej opisuje narzędzia; nie zastępuje dowodów wykonania konkretnej próby.
- Open WebUI - RAG i diagnostyka pobierania.
- Qdrant - wyszukiwanie wektorowe.
- LM Studio - lokalny serwer.
- AquiLLM: Evaluating Faithfulness in Open-Weight RAG-LLM Systems for Scientific Research, Boscoe i współautorzy, 2026.
- Faithfulness-QA: A Counterfactual Entity Substitution Dataset for Training Context-Faithful RAG Models, Ju, Wang i Zhang, 2026.
Pytania i odpowiedzi
Czy RAG gwarantuje poprawną odpowiedź?
Nie. W tych próbach błędy wynikały z braku potrzebnego fragmentu oraz z interpretacji treści, która została pobrana.
Czy zwiększenie K rozwiązało problem?
Poprawa wystąpiła po zmianie, ale utrzymała się po powrocie do mniejszej wartości. Nie potwierdziłem wpływu samego limitu.
Czy nagłówek przy każdej pozycji pomógł?
W próbie porównawczej oba warianty wskazały A.5.23, czyli zabezpieczenie dotyczące usług chmurowych. Wariant z nagłówkami zwrócił pojedyncze pozycje listy, ale model dołączył numer porządkowy „23.” do identyfikatora. Nie wykazano poprawy jakości odpowiedzi po dodaniu nagłówków.
Czy polecenie przeszukania całego dokumentu wystarcza?
Nie jest dowodem pełnego odczytu. Trzeba sprawdzić, jakie fragmenty rzeczywiście dostarczono modelowi.
Dlaczego uprościłem rozwiązanie?
Wbudowany RAG ograniczył utrzymanie własnego importera i pośrednika. Nie zwolnił z kontroli odpowiedzi.
Jak zacząć mały test?
Wybrać dokument i pytanie ze znaną odpowiedzią. Zapisać pobrane fragmenty oraz odpowiedź. Zmienić jeden element i wykonać kontrolę rozstrzygającą konkretną hipotezę.