


Cel i zakres własnego wdrożenia
Projekt zrealizowałem w prywatnym laboratorium opartym na Proxmox VE. Był sprawdzianem moich umiejętności uruchomienia monitoringu i przygotowania wizualizacji, a także okazją do poznania zachowania własnej infrastruktury.
Zabbix uruchomiłem jako kontener LXC, korzystając z gotowego skryptu instalacyjnego. Grafana działała w osobnym kontenerze, z integracją z Zabbix przez API. Zakres obejmował hypervisor oraz wybrane maszyny wirtualne.
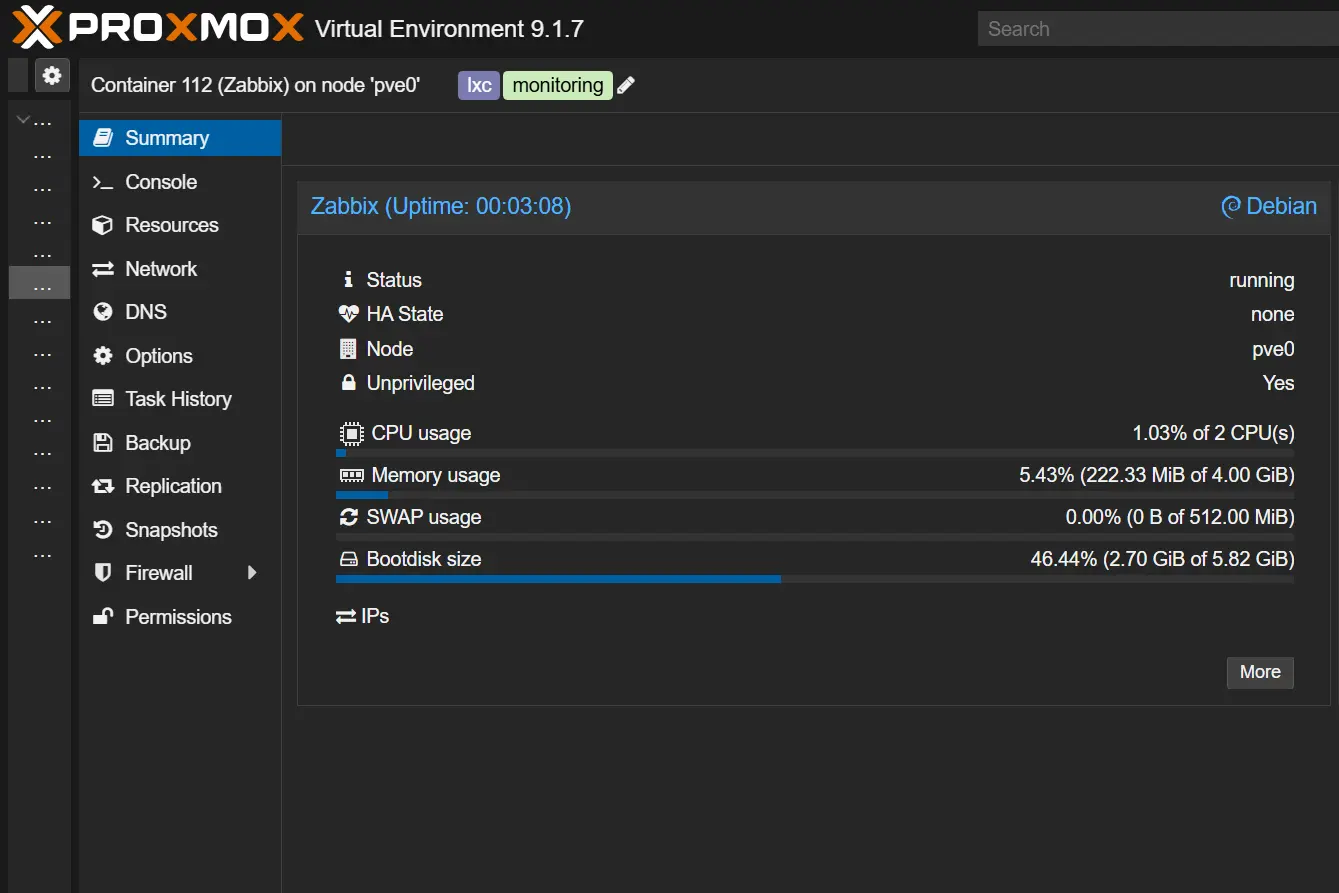
Zabbix jako kontener LXC w prywatnym środowisku Proxmox.
Zakres monitorowania wynika ze znaczenia zasobów
Interesowały mnie parametry zasobów serwera, ruch sieciowy i dostępność wybranych maszyn wirtualnych. Przy doborze zakresu kierowałem się znaczeniem danego elementu dla działania laboratorium.
Podobnie podchodzę do większych środowisk: najpierw trzeba wskazać kluczowe usługi i konsekwencje ich niedostępności. Dopiero potem dobierać dane, częstotliwość obserwacji i potrzebę alarmowania. Sam fakt, że narzędzie udostępnia parametr, nie oznacza jeszcze, że jego zbieranie jest potrzebne.
Dla kluczowych usług ważna jest aktualna informacja o stanie. Tam, gdzie potrzebna jest szybka reakcja, zakres powinien obejmować również odpowiednie powiadomienia.
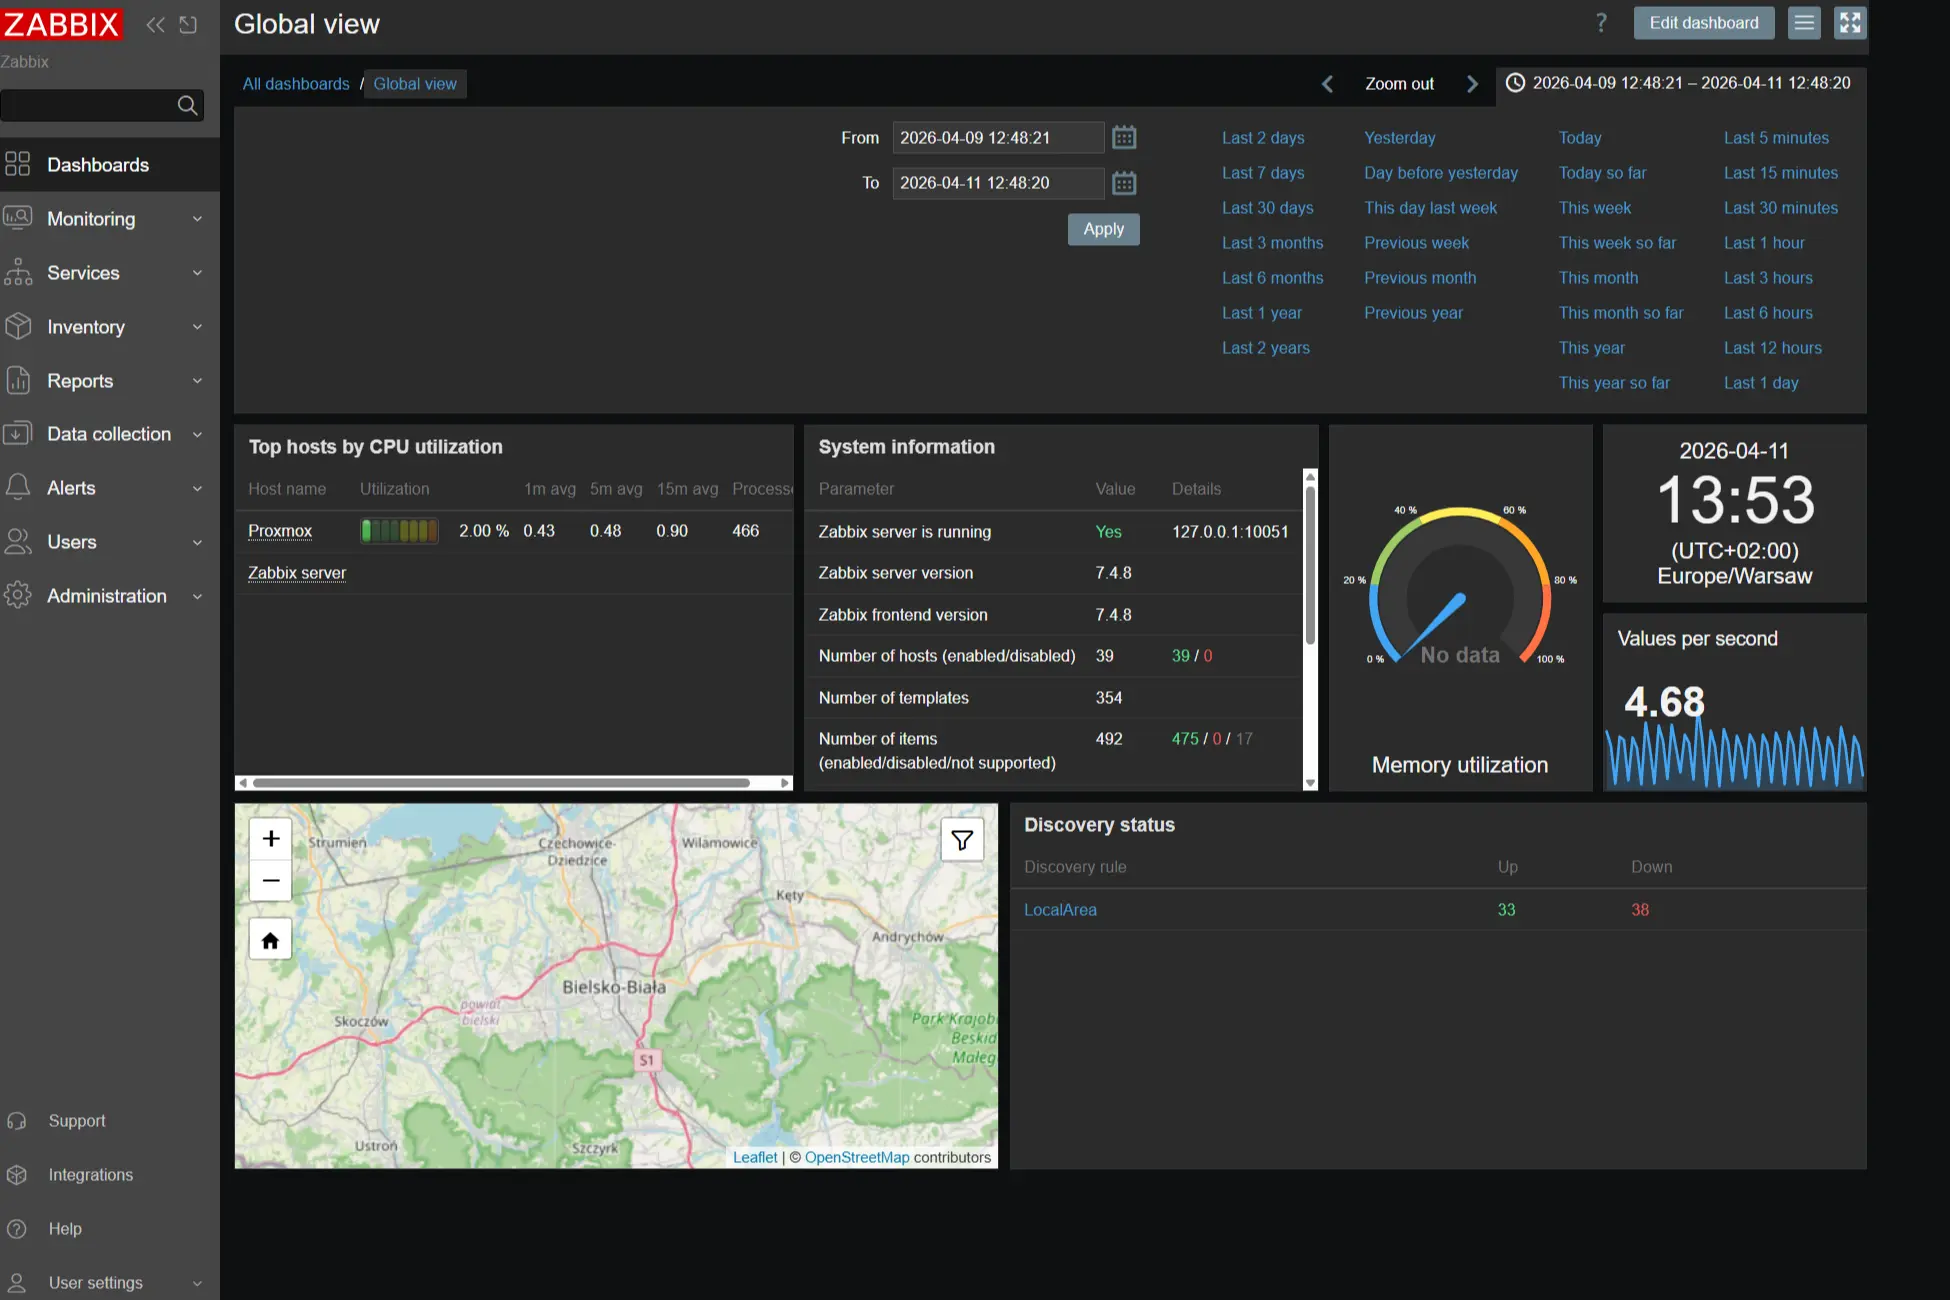
Przegląd monitorowanych hostów i wybranych parametrów w Zabbix.
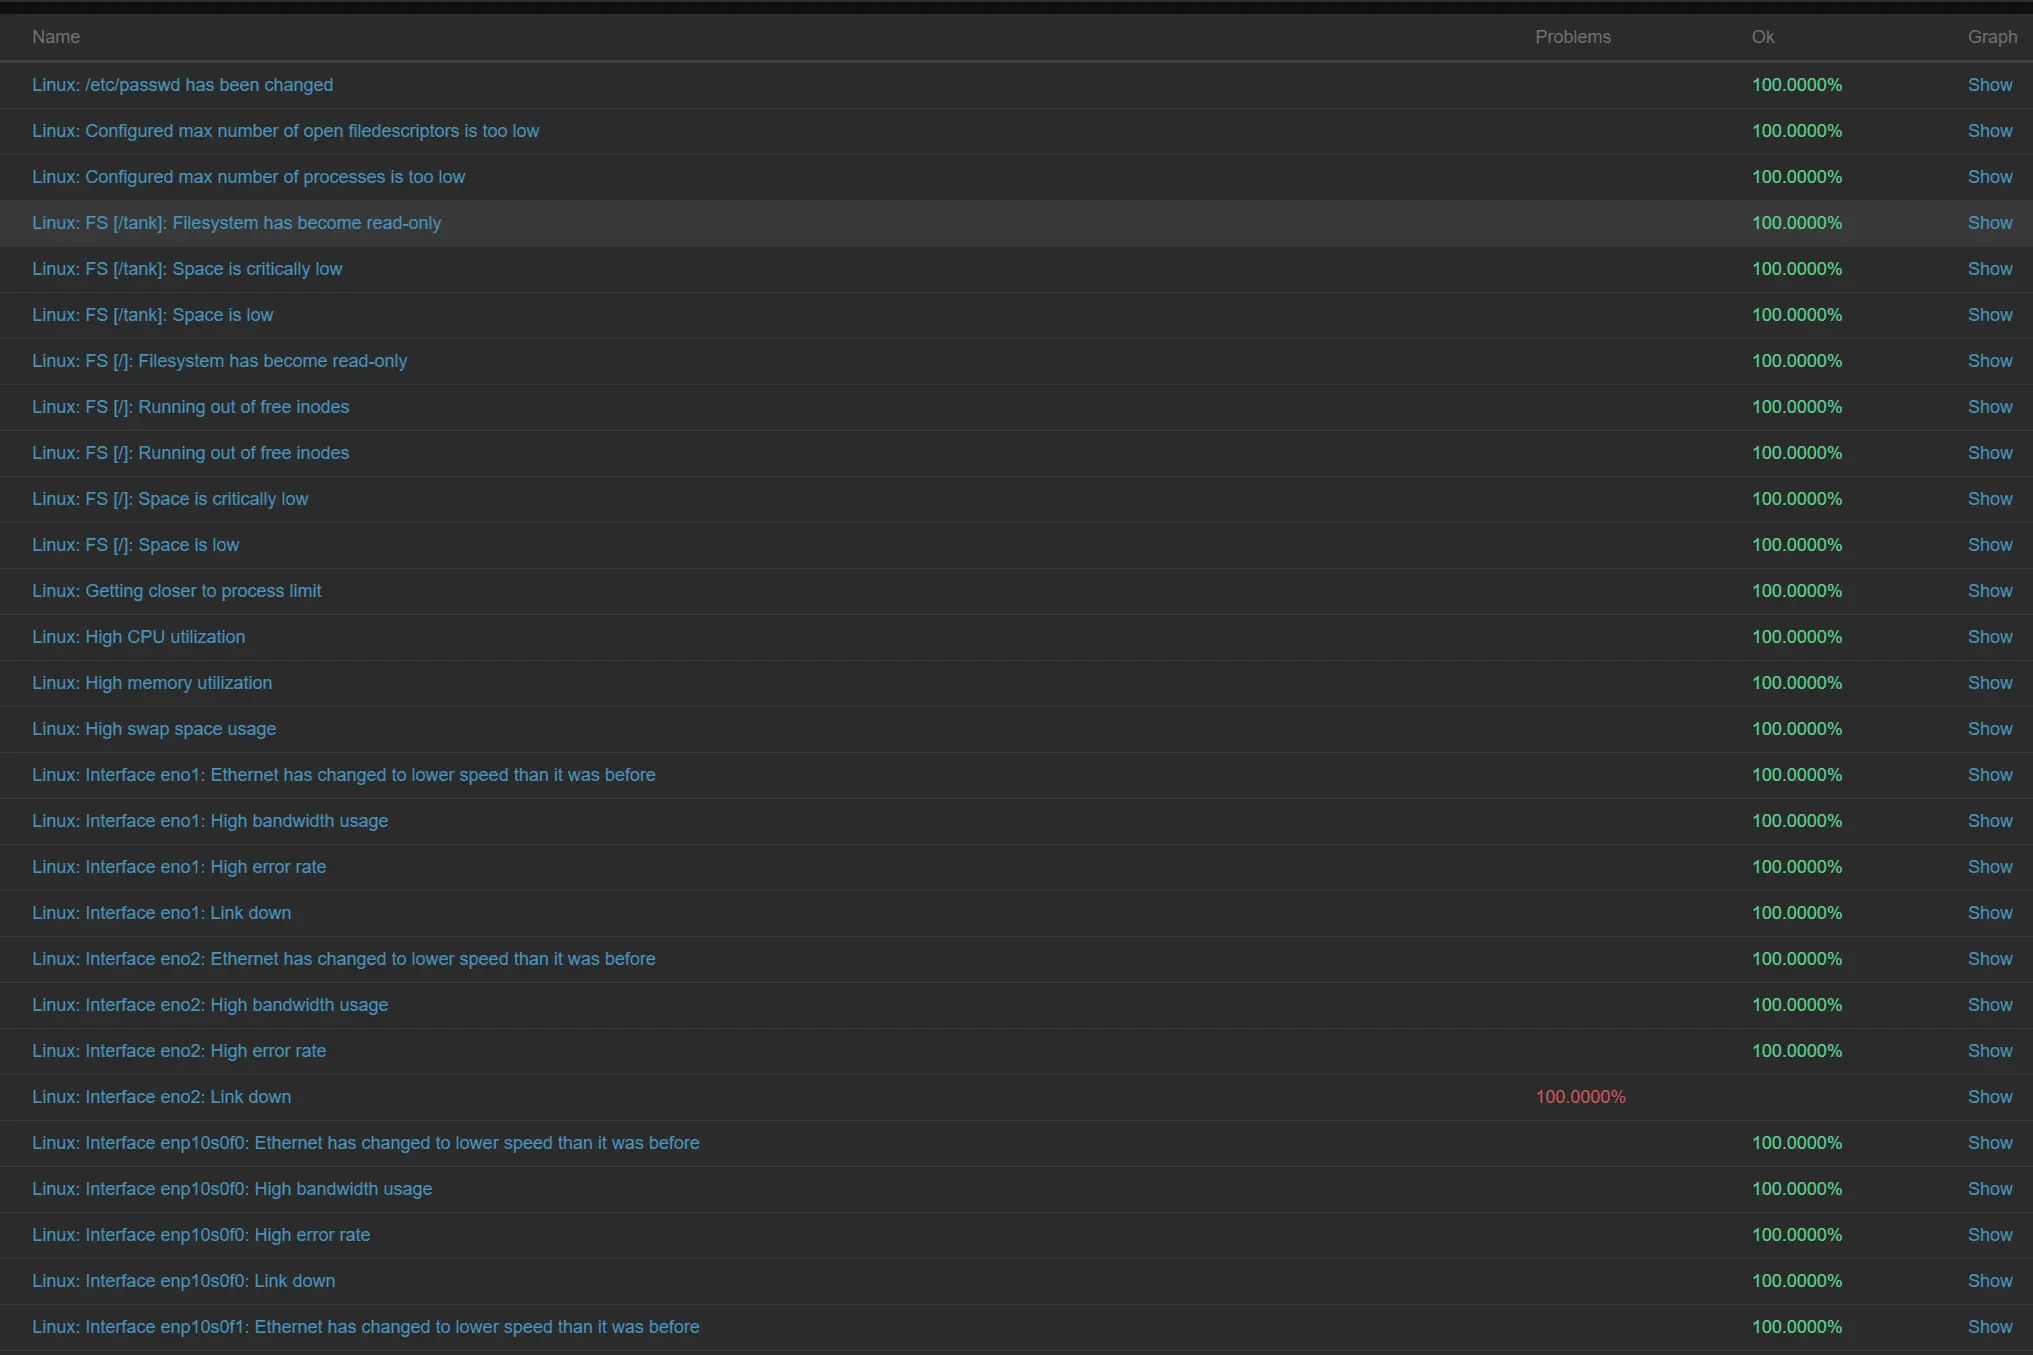
Widok dostępności monitorowanych hostów w Zabbix.
Grafana - czytelny obraz wybranych danych
Zabbix zapewniał monitoring zasobów. W Grafanie chciałem zbudować estetyczny i przystępny widok, dopasowany do tego, co sam chciałem obserwować. Zależało mi na zebraniu najważniejszych informacji na jednym dashboardzie.
Ten cel udało się osiągnąć. Wspólny widok ułatwiał przegląd wybranych parametrów bez przechodzenia między osobnymi ekranami. Czytelność prezentacji była dla mnie częścią użyteczności rozwiązania: dane miały pomagać w rozpoznawaniu sytuacji i podejmowaniu kolejnych działań.
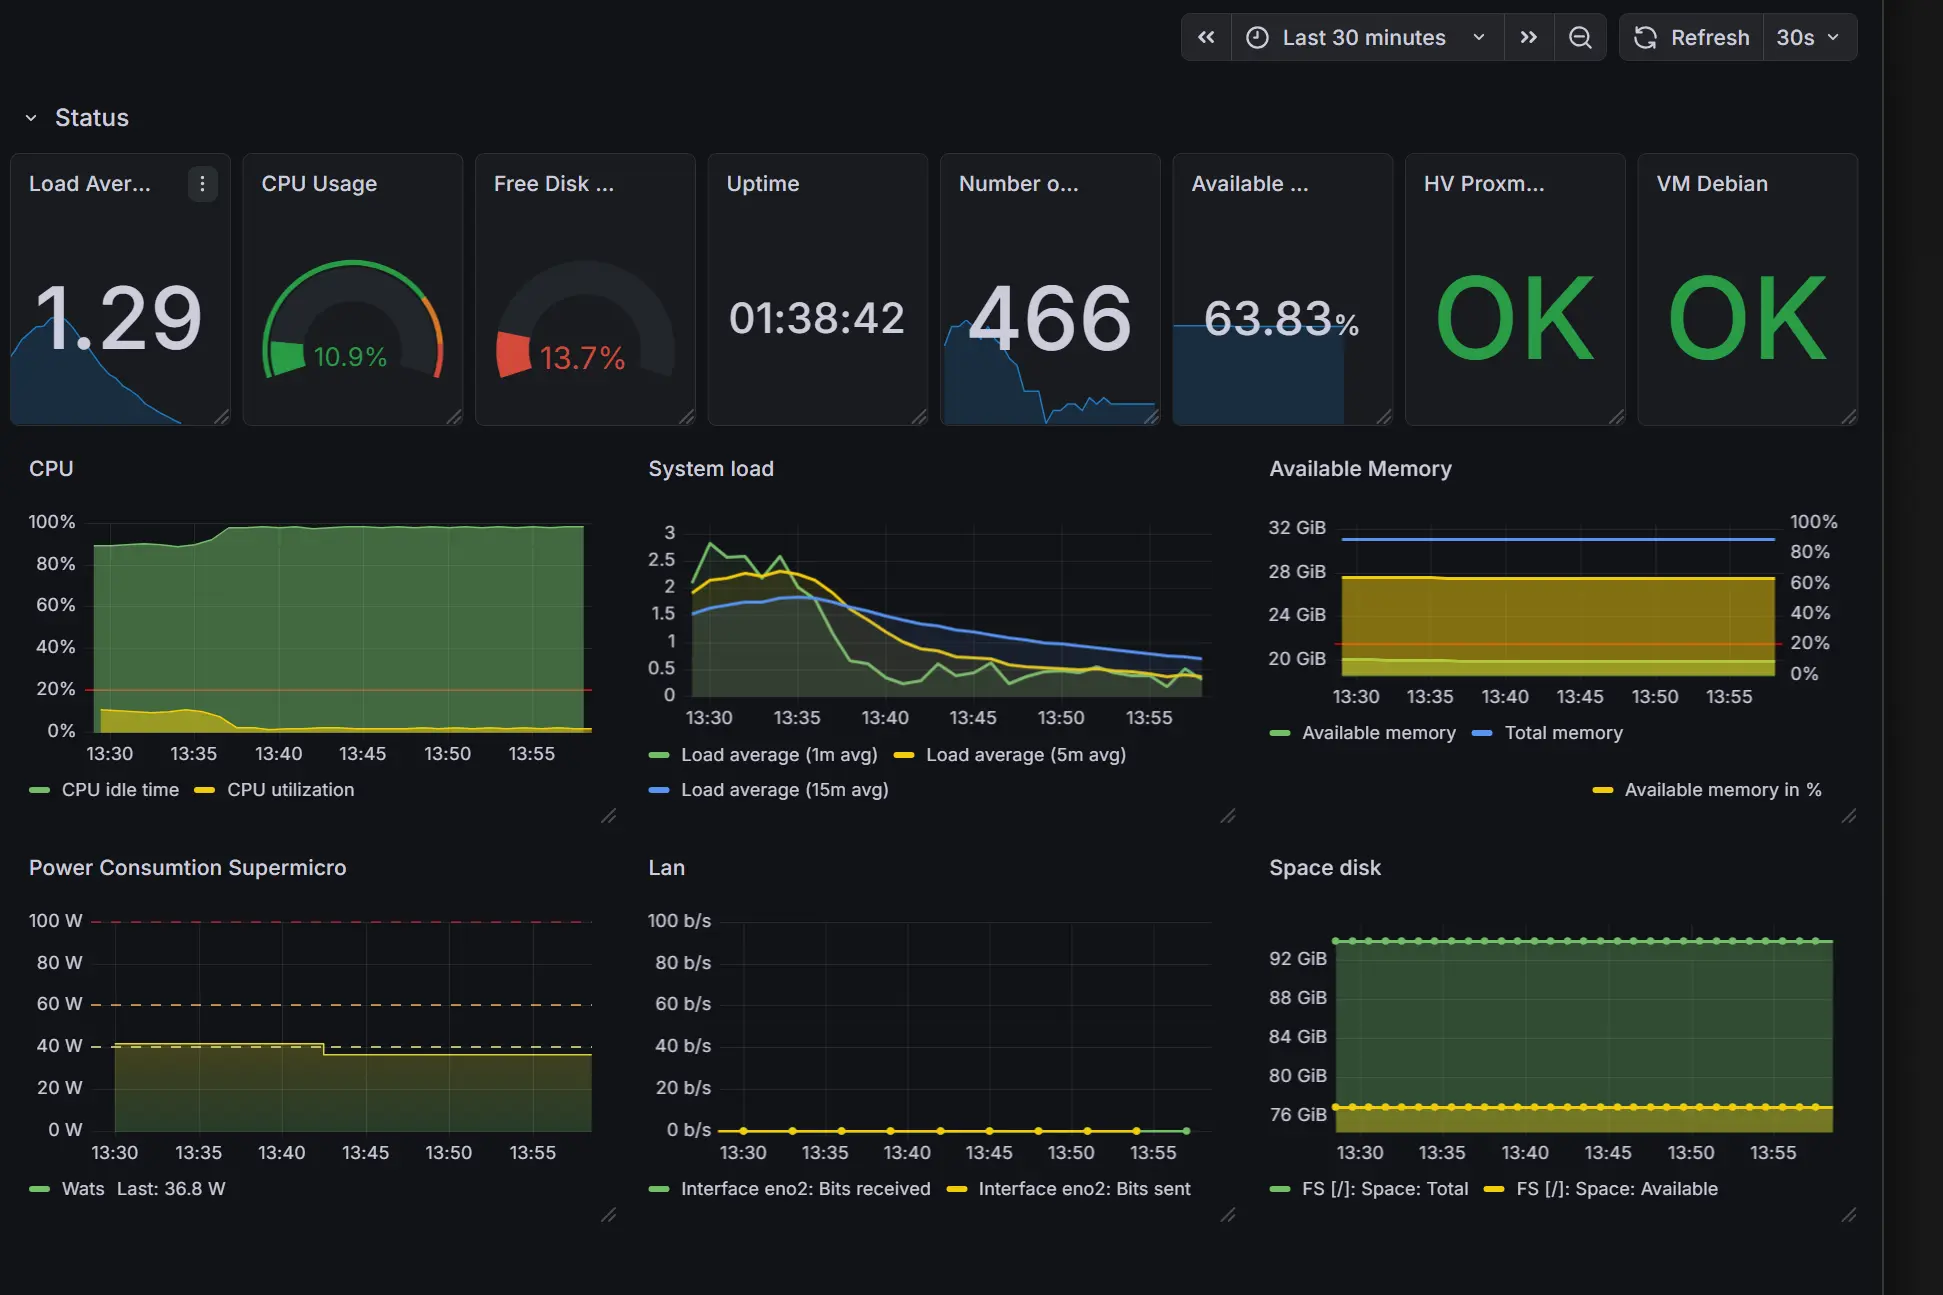
Wspólny dashboard z wybranymi danymi monitoringu w Grafanie.
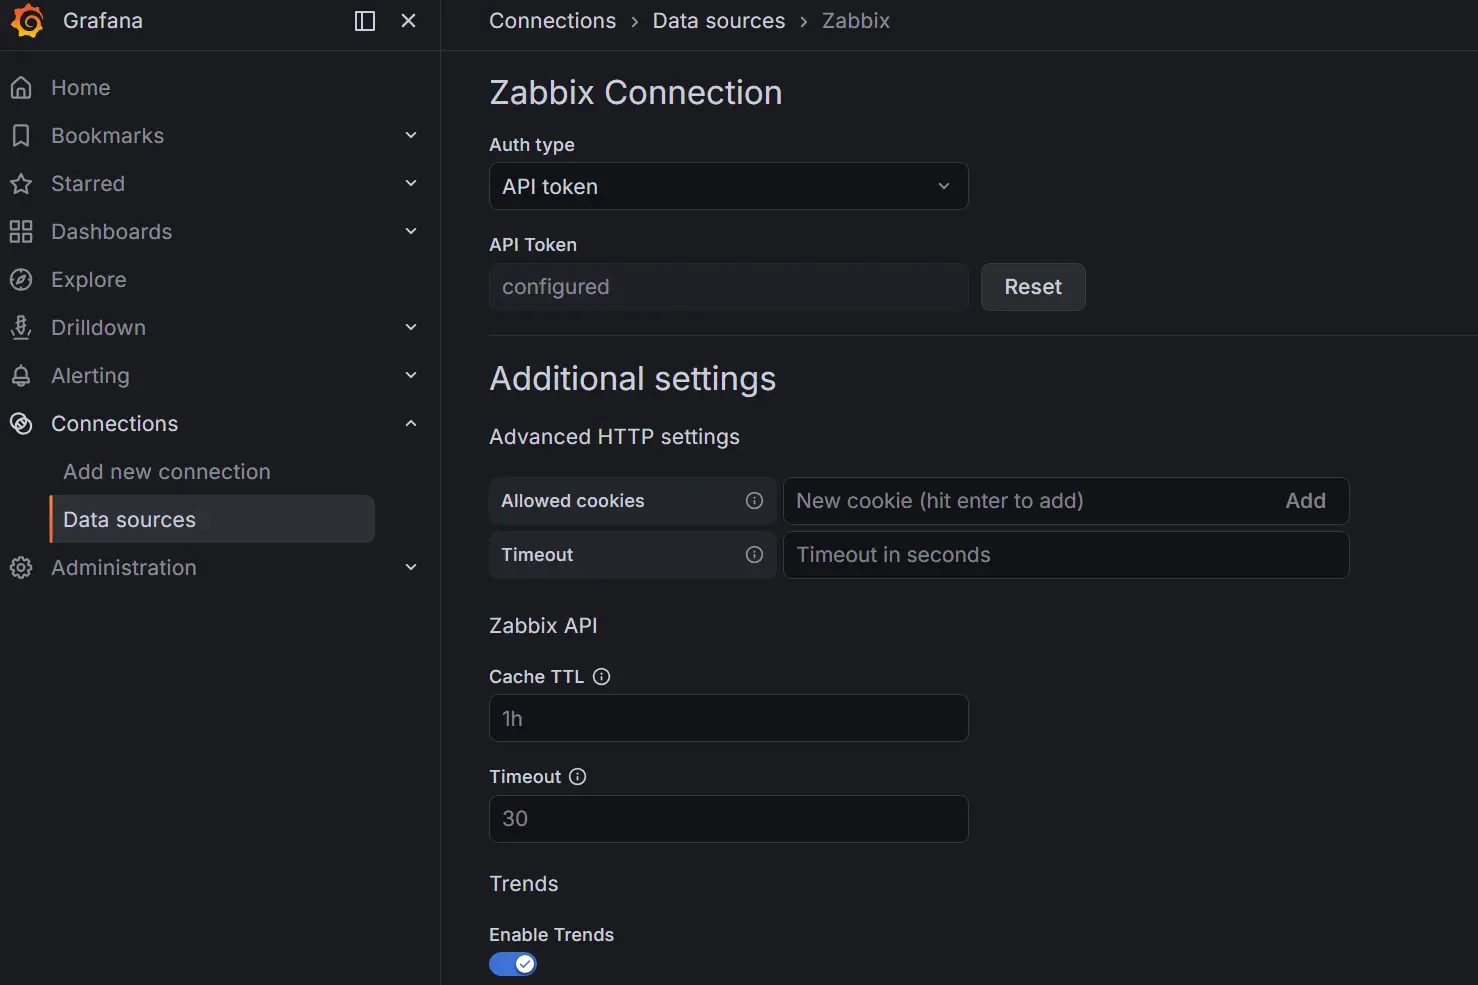
Integracja Grafany z Zabbix przez API.
Co pokazała obserwacja środowiska
Zwiększony ruch sieciowy obserwowałem podczas wykonywania kopii zapasowych i skanowania sieci. Był to praktyczny przykład tego, że również w niewielkim środowisku czynności utrzymaniowe trzeba planować z uwzględnieniem obciążenia.
Wniosek dotyczył doboru czasu i zakresu takich działań, szczególnie gdy mogą odbywać się jednocześnie. Nie traktuję tej obserwacji jako dowodu, że sam monitoring powodował przeciążenie. Zarejestrowana zmiana jest punktem wyjścia do oceny, a ustalenie przyczyny wymaga uwzględnienia tego, co w danym czasie wykonywało środowisko.
Od obserwacji do automatyzacji i optymalizacji
Monitoring pomógł mi w dalszym usprawnianiu laboratorium. Jedną z wprowadzonych zmian była automatyzacja cyklu pracy serwera: uruchomienie, wykonanie kopii zapasowych i wyłączenie. Serwer nie pracuje przez całą dobę, ponieważ jego zadanie w tym środowisku nie wymaga takiej dostępności.
Ograniczenie zużycia energii uwzględniałem od początku projektowania serwera. Pracowałem również nad ustawieniami zarządzania energią w czasie jego działania, korzystając pomocniczo z diagnostyki PowerTOP. Dobór czasu pracy oraz ustawienia były dwoma uzupełniającymi się obszarami usprawnień.
Dlaczego nie rozbudowywałem powiadomień
W tym wdrożeniu nie skonfigurowałem aktywnych powiadomień. Przy niewielkiej skali, testowym celu i serwerze pracującym w określonym oknie wystarczała mi obserwacja danych.
Tego wyboru nie przenosiłbym automatycznie na środowisko wymagające ciągłej dostępności. Potrzebę alarmowania należy powiązać ze znaczeniem usługi, dopuszczalnym czasem reakcji i odpowiedzialnością za działanie.
Wniosek z perspektywy audytowej
Po tym doświadczeniu zapytałbym właściciela procesu monitorowania, czy objął nim wszystkie aplikacje, systemy i serwery uznane za kluczowe. Jeżeli część z nich pozostaje poza zakresem, chciałbym wiedzieć, czy decyzję poprzedziła analiza ryzyka i na czym oparto jej uzasadnienie.
Interesuje mnie związek między potrzebą, zakresem obserwacji i wykorzystaniem danych. Samo uruchomienie narzędzia nie wyjaśnia jeszcze, czy organizacja obserwuje to, co jest dla niej istotne.
Wyniki i ograniczenia projektu
Uruchomiłem monitoring wybranych zasobów oraz wspólny dashboard. Obserwacja środowiska wspierała dalsze usprawnienia, w tym automatyzację cyklu pracy serwera i działania dotyczące zarządzania energią.
To opis prywatnego środowiska testowego. Nie przedstawia pomiarów skuteczności alarmowania, dostępności produkcyjnej ani kontrolowanego porównania zużycia energii. Wnioski dotyczą celu i zakresu tego projektu.
Przełożenie na biznes
W organizacji zakres monitorowania powinien wynikać ze znaczenia usług dla procesów biznesowych. Punktem wyjścia jest ustalenie, co musi działać, jakie skutki miałaby niedostępność i kto powinien zareagować. Dopiero na tej podstawie dobierałbym metryki, progi i powiadomienia.
Czytelny dashboard może ułatwiać ocenę sytuacji zarówno osobom technicznym, jak i właścicielom procesów. Jego wartość zależy od tego, czy przedstawione informacje pomagają podjąć decyzję: sprawdzić przyczynę odchylenia, zaplanować zasoby lub zmienić harmonogram prac.
Automatyzacja czasu pracy serwera w moim laboratorium ilustruje szerszą zasadę: dostępność zasobów warto dopasować do rzeczywistych potrzeb. W firmie taka decyzja wymaga uwzględnienia zależności, ciągłości działania i ryzyka. Część usług musi działać całodobowo, a inne mogą pracować w określonych oknach. Monitoring dostarcza danych do oceny, gdzie usprawnienie jest uzasadnione.
Podsumowanie
Najważniejsze było dla mnie przejście od uruchomienia narzędzi do wykorzystania obserwacji. Zabbix dał wgląd w wybrane zasoby, Grafana pomogła czytelnie przedstawić dane, a kolejne decyzje dotyczyły sposobu pracy infrastruktury. Tak rozumiem wartość monitoringu w tym projekcie: dane pomagają ocenić sytuację i wybrać uzasadnione usprawnienie.
Źródła i dokumentacja
Pytania i odpowiedzi
Czy projekt obejmował całą infrastrukturę?
Nie. Zakres obejmował hypervisor i wybrane maszyny wirtualne. Dobór wynikał z potrzeb laboratorium i znaczenia obserwowanych elementów.
Jaką rolę pełniła Grafana?
Przedstawiała wybrane dane z Zabbix na wspólnym dashboardzie. Celem była czytelna i estetyczna prezentacja informacji potrzebnych do obserwacji środowiska.
Czy automatyzacja backupu jest funkcją tego dashboardu?
Automatyzacja cyklu pracy serwera była osobnym usprawnieniem laboratorium. Opis nie przypisuje jej wykonania Zabbixowi ani Grafanie.
